Универсального ТЗ на чат-бота не существует. Задание для простого Telegram-бота с кнопками и для корпоративного LLM-ассистента с доступом к базе знаний — это два разных документа. Без этапа проектирования получите бота, который путается в ответах, выдумывает факты или ломается на нестандартном вопросе. В статье разберем, как составить ТЗ пошагово: от бизнес-задачи и выбора канала (Telegram, сайт, Mattermost) до архитектуры на Laravel и Node.js, подключения LLM-API и подхода RAG для поиска по данным компании. Покажем, как собрать прототип за 30 минут и что нужно, чтобы довести его до рабочего решения с тестированием и контролем точности.
- Универсального ТЗ для чат-ботов не существует — задание зависит от бизнес-цели (поддержка, продажи, HR-процессы), канала (Telegram, сайт, Mattermost) и требуемых интеграций
- Точность ответов обеспечивает RAG-подход: система ищет релевантные фрагменты в корпоративной базе знаний и передает их LLM, исключая галлюцинации и выдуманные факты
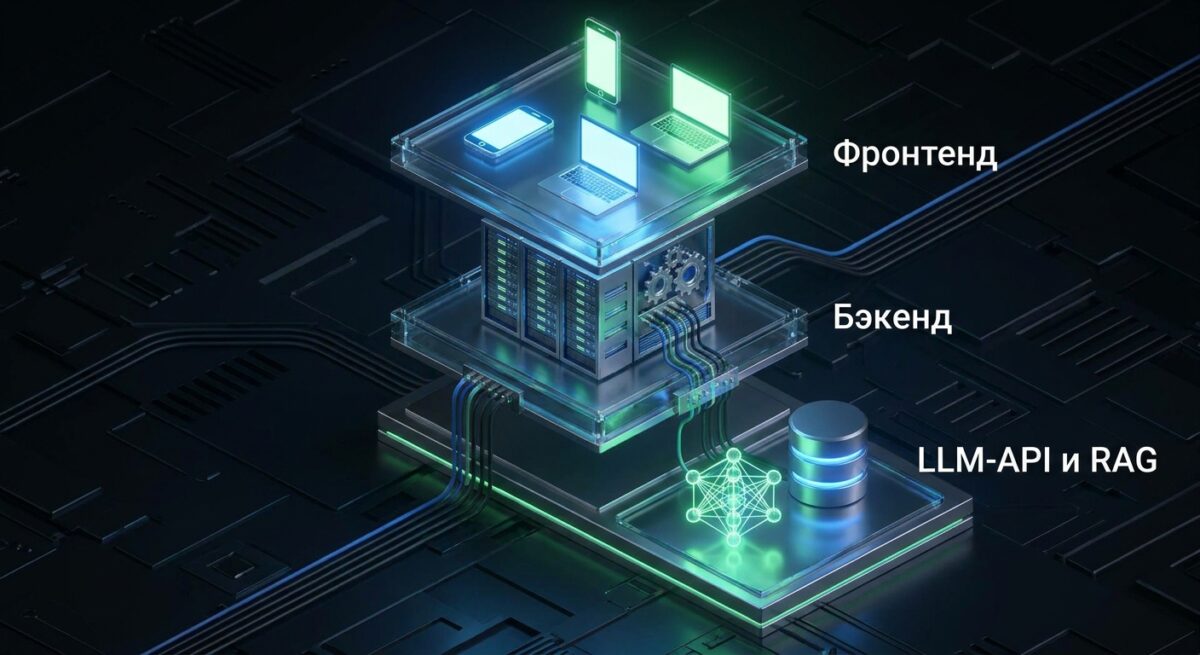
- Архитектура состоит из трех слоев — фронтенд (JS-виджет, мессенджер), бэкенд (Laravel/Node.js с логикой и историей), LLM-API с интеграциями; разделение позволяет менять компоненты независимо
- Перед продакшеном обязательны три этапа тестирования: ручные прогоны по чек-листам сценариев, измерение метрик релевантности (не менее 90% ответов с опорой на источник) и мониторинг реальных диалогов в закрытом контуре компании
Анатомия бизнес-задачи: почему универсальный шаблон технического задания — это миф
ТЗ начинается не с описания кнопок, а с ответа на вопрос: какую задачу бизнеса решает бот. Бот поддержки разгружает операторов и работает с базой обращений. Бот продаж ведет клиента по воронке и подключает CRM. HR-бот собирает заявки на отпуск и отвечает по внутренним регламентам. Под каждую цель нужны разные данные, разные интеграции и разные метрики успеха. Шаблон «опишу чат-бота один раз» не работает: он игнорирует, откуда бот берет ответы, кому пишет и что делает при сбое. Сначала фиксируют бизнес-задачу, потом архитектуру и текст ТЗ подгоняют под нее.
Разделение проектов по целям: поддержка, продажи и HR-процессы
Бот поддержки отвечает на повторяющиеся вопросы и передает сложные обращения оператору. В ТЗ для него ключевые пункты: источники ответов (FAQ, база знаний, тикет-система), правило эскалации на человека и лог всех диалогов для разбора ошибок. Метрика — доля закрытых без оператора обращений и точность ответов. Бот продаж работает иначе: он квалифицирует лид, задает уточняющие вопросы и пишет данные в CRM. Здесь важны интеграция с amoCRM или Bitrix24 и сценарий догрева, а не глубокая база знаний.
- Бот поддержки: Интеграция с FAQ и тикет-системами, фокус на метрике закрытых обращений без участия человека.
- Бот продаж: Синхронизация с CRM-системами, квалификация лидов по воронке и сценарии прогрева.
- HR-бот: Работа с внутренними корпоративными регламентами, строгий контроль доступов и защита персональных данных сотрудников.
HR-бот закрывает внутренние процессы: заявки на отпуск, справки, ответы по корпоративным регламентам. Его особенность — работа с чувствительными данными сотрудников, поэтому в ТЗ отдельно прописывают контроль доступа и хранение внутри контура компании. Три эти задачи требуют разных источников данных и разных гарантий по безопасности. Попытка описать их одним заданием приводит к тому, что бот либо перегружен ненужными функциями, либо не решает основную задачу. Поэтому первый раздел ТЗ — это цель и границы проекта.
Выбор каналов коммуникации: от Telegram и сайта до закрытого Mattermost
Канал определяет технические ограничения, которые попадают в ТЗ. Telegram работает через Bot API, поддерживает кнопки, inline-режим и вебхуки — это самый быстрый старт для внешней аудитории. Веб-чат на сайте требует фронтенда на JavaScript, виджета и обработки сессий, зато дает полный контроль над интерфейсом и брендингом. Для каждого канала в задании прописывают формат сообщений, лимиты на длину и частоту, а также способ авторизации пользователя.
Mattermost и другие корпоративные мессенджеры выбирают, когда бот работает с внутренними данными и не должен выходить за периметр компании. Здесь важны self-hosted развертывание, интеграция через входящие вебхуки и slash-команды, а также контроль доступа по ролям. Один бот может обслуживать несколько каналов сразу, но логику ответов удобнее выносить в общий backend, а каждый канал подключать отдельным адаптером. Это решение фиксируют в архитектурном разделе ТЗ, чтобы избежать дублирования кода.
При внедрении ИИ в HR-процессы безопасность выходит на первый план. Специалисты AiForSite отмечают, что для таких задач оптимальным выбором становятся self-hosted решения вроде Mattermost, где все переписки остаются строго внутри корпоративного периметра.
Переход от быстрых прототипов за 30 минут к серьезным корпоративным решениям
Прототип собирают на конструкторе вроде Botmother или на готовом SDK за полчаса: подключают токен Telegram-бота, задают пару сценариев с кнопками и проверяют, что сообщения доходят. Такой прототип показывает заказчику логику диалога и помогает уточнить требования до написания полного ТЗ. Но он не умеет искать по данным компании, не защищен от галлюцинаций и не масштабируется под нагрузку — для демонстрации этого достаточно, для эксплуатации нет.
Чтобы превратить прототип в корпоративное решение, ТЗ дополняют серьезными разделами. Backend на Laravel или в облаке обрабатывает запросы и хранит логи. LLM-API отвечает на свободные вопросы, а подход RAG подставляет в ответ фрагменты из базы знаний, снижая выдумки. Отдельно прописывают политику ответов, ручное тестирование сценариев по чек-листам и метрики точности. Именно эти пункты отличают надежного бота, которому бизнес доверяет, от демо-версии на один показ.
🤖 ИИ-ассистент, который увеличивает конверсию
AiForSite — умный ИИ-помощник для вашего ресурса. Внедрите нейросеть за пару кликов, автоматизируйте общение с клиентами и собирайте лиды 24/7 без участия менеджера. Искусственный интеллект на ваш сайт!
Архитектурный стек ИИ-ассистента: фронтенд, бэкенд и языковые модели
ИИ-ассистент состоит из трех слоев. Фронтенд принимает сообщения пользователя: это JS-виджет на сайте, чат в Telegram или окно в корпоративном Mattermost. Бэкенд на Laravel или Node.js обрабатывает запросы, хранит историю диалогов и решает, куда направить сообщение. Языковая модель (LLM) через API генерирует ответ, а при подходе RAG сначала ищет нужный фрагмент в базе знаний компании. Разделение на слои позволяет менять каналы или модель без переписывания всей системы. В ТЗ каждый слой описывают отдельно: интерфейсы, серверные эндпоинты и правила обращения к LLM.
Роль клиентской части: интеграция JS-виджетов и интерфейсов мессенджеров
Клиентская часть определяет, как пользователь видит бота. Для сайта используют JS-виджет: скрипт вставляют в страницу, он открывает окно чата и отправляет сообщения на бэкенд через WebSocket или REST. В Telegram роль интерфейса выполняет сам мессенджер, а бот получает данные через Bot API. Mattermost работает по схожему принципу через слэш-команды и вебхуки. В ТЗ фиксируют список каналов и способ подключения каждого.
Разные каналы диктуют разные ограничения. Telegram поддерживает inline-кнопки и лимит на длину сообщения 4096 символов. Веб-виджет позволяет показывать HTML, карточки товаров и формы. Эти детали влияют на то, как бэкенд форматирует ответ LLM. Поэтому в ТЗ для каждого канала прописывают формат сообщений, набор кнопок и поведение при длинном ответе модели.
Серверная логика на Laravel и Node.js для обработки входящих запросов
Бэкенд принимает вебхуки от каналов, извлекает текст запроса и определяет сценарий. Laravel подходит, если бот встраивается в существующую CRM или админку на PHP: очереди, авторизация и работа с БД идут из коробки. Node.js выбирают для высокой нагрузки и стриминга ответов LLM в реальном времени. В ТЗ указывают стек, структуру эндпоинтов и схему хранения истории диалогов в базе.
Выбор серверного стека напрямую зависит от типа нагрузки. Если для интеграции с классическими CRM и админками идеально подходит экосистема Laravel, то для обработки потоковых ответов от LLM в реальном времени лучше справляется Node.js.
Сервер также управляет контекстом. Он собирает предыдущие реплики, добавляет системный промпт с ролью бота и передает пакет в LLM-API. При RAG бэкенд сначала обращается к векторной базе, находит релевантные фрагменты документов компании и вставляет их в запрос. В ТЗ описывают лимит на размер контекста, правила очистки истории и обработку ошибок, когда модель или база недоступны.
Интеграция LLM-API и организация безопасного обмена данными
LLM-API подключают по HTTP-запросу с ключом авторизации. Бэкенд отправляет промпт и параметры (модель, температуру, максимум токенов), получает ответ и передает его в канал. В ТЗ фиксируют выбор провайдера, лимиты токенов и логику повторных попыток при таймауте. Отдельно указывают, стримить ответ по частям или отдавать целиком — это влияет на восприятие скорости.
Безопасность данных — ключевой пункт для корпоративного бота. Персональные и коммерческие данные не отправляют в LLM без необходимости: их маскируют или заменяют плейсхолдерами. Ключи API хранят в переменных окружения, а не в коде. Если политика компании запрещает передачу данных во внешние сервисы, в ТЗ закладывают локальную модель или облако с гарантией непередачи данных на обучение. Также прописывают логирование запросов для аудита.
| Параметр безопасности | Публичные LLM-API (OpenAI, Anthropic) | Локальные модели (Self-hosted) |
|---|---|---|
| Хранение данных | На серверах провайдера (требуется маскирование) | Строго внутри корпоративного контура |
| Риск утечки | Присутствует (зависит от политики провайдера) | Минимальный (изолированная среда) |
| Сложность внедрения | Низкая (подключение по ключу API) | Высокая (требуются мощные GPU-серверы) |
Обучение модели на данных компании: как обеспечить точность без галлюцинаций
LLM не нужно дообучать на данных компании, чтобы она отвечала по вашим документам. Дообучение (fine-tuning) стоит дорого, требует размеченных датасетов и не решает главную проблему — модель все равно выдумывает факты, которых нет в источнике. Вместо этого бота подключают к корпоративным данным через RAG: модель получает нужный фрагмент документа в момент запроса и отвечает строго по нему. Точность зависит от трех факторов: качества поиска по базе знаний, чистоты исходных документов и жестких инструкций в системном промпте. Разберем каждый механизм и покажем, как они вместе снижают риск галлюцинаций до приемлемого для бизнеса уровня.
Применение RAG-подхода для поиска по внутренним корпоративным базам знаний
RAG (Retrieval-Augmented Generation) работает по схеме «сначала найди, потом ответь«. Когда пользователь задает вопрос, система переводит его в вектор, ищет в базе релевантные фрагменты документов и передает их модели вместе с исходным запросом. Модель формулирует ответ только на основе полученного контекста, а не на своих внутренних «знаниях». Это отсекает выдуманные факты: если в базе нет ответа, бот сообщает об этом, а не фантазирует.
В ТЗ по RAG фиксируют: какую векторную базу использовать (Qdrant, Weaviate, pgvector в PostgreSQL), какую модель эмбеддингов подключить, сколько фрагментов подавать в контекст и по какому порогу релевантности отсекать нерелевантные куски. Отдельно прописывают требование возвращать ссылку на источник — номер документа или раздела. Так менеджер сможет проверить, откуда бот взял ответ, а пользователь получит подтверждение достоверности.
Очистка и структурирование документов перед загрузкой в векторную базу
Качество ответов бота прямо зависит от чистоты исходных данных. PDF со сканами, таблицы без разметки, дубли инструкций и устаревшие версии регламентов ломают поиск: модель получает мусорный контекст и выдает противоречивые ответы. Перед загрузкой документы приводят к единому текстовому формату, удаляют колонтитулы, водяные знаки и служебную верстку, таблицы преобразуют в структурированный вид.
Дальше текст разбивают на фрагменты — чанки. В ТЗ указывают размер чанка (обычно 300–800 токенов) и перекрытие между ними, чтобы смысл не рвался на границах. К каждому фрагменту добавляют метаданные: раздел, дата обновления, тип документа. Это позволяет фильтровать выдачу и показывать только актуальные версии. Отдельно описывают регламент обновления базы: как часто перезагружать документы и кто отвечает за удаление устаревших.
Установка жестких системных промптов и политик безопасности ответов
Системный промпт задает боту рамки поведения. В нем прописывают роль («ты ассистент поддержки компании«), запрет отвечать на вопросы вне контекста базы знаний и обязательную формулировку отказа, если ответ не найден. Пример правила: «Отвечай только на основе предоставленных фрагментов. Если информации недостаточно — скажи об этом и предложи связаться с оператором». Это блокирует попытки модели домыслить ответ.
Системный промпт — это главный предохранитель от нейросетевых галлюцинаций. Жесткий запрет на использование знаний вне контекста векторной базы снижает риск генерации выдуманных фактов до минимума.
Политики безопасности защищают от утечек и злоупотреблений. В ТЗ фиксируют список запретных тем, фильтрацию персональных данных в логах и защиту от prompt injection — попыток пользователя переписать инструкции бота через сам вопрос. Прописывают эскалацию: при каких условиях диалог передается человеку. Все эти правила проверяют вручную по чек-листу сценариев перед запуском — без такого тестирования корпоративный бот в продакшн не выпускают.
Инструменты разработки и развертывания: от визуальных конструкторов до кастомного кода
Выбор инструмента зависит от сложности бота и требований к контролю над данными. Визуальные конструкторы вроде Botmother позволяют собрать сценарий с кнопками за пару часов без программиста. Кастомный код на Laravel или Node.js нужен, когда бот работает с корпоративной базой, вызывает LLM-API и требует нестандартной логики. Между этими полюсами — гибридные схемы: прототип на конструкторе для проверки гипотезы, затем перенос критичных частей в собственный бекенд. В ТЗ сразу зафиксируйте, где проходит граница: что делает готовая платформа, а что пишется руками под ваши процессы.
Использование готовых платформ автоматизации вроде Botmother
Конструктор Botmother собирает бота из блоков: сообщение, кнопка, условие, запрос к API. Один проект публикуется сразу в Telegram, ВКонтакте и на сайт без переписывания логики. Это ускоряет запуск бота поддержки или FAQ, где сценарии предсказуемы и не требуют генерации текста нейросетью. За 30 минут вы собираете рабочий прототип с приветствием, меню и переходами — его можно показать заказчику и проверить, попадает ли структура диалога в реальные запросы пользователей.
Ограничение конструкторов — слабый контроль над данными и вычислениями на стороне сервера. Сложную обработку, интеграцию с CRM компании или подключение LLM с поиском по документам через них не выстроить надежно. В ТЗ для платформы описывайте конкретно: список экранов, тексты кнопок, условия ветвления и точки вызова внешнего API. Как только логика упирается в приватные данные или требует RAG-поиска, готовьтесь выносить эту часть в собственный бекенд.
Развертывание телеграм-ботов через вебхуки и защищенные серверы
Telegram доставляет сообщения боту двумя способами: long polling и webhook. Polling подходит для локальной разработки, когда сервер сам опрашивает Telegram. Для продакшена используют webhook: Telegram шлет обновления POST-запросом на ваш HTTPS-адрес сразу при поступлении сообщения. Это снижает задержку и нагрузку. Обязательное условие — валидный TLS-сертификат и открытый порт 443, 80, 88 или 8443. В ТЗ пропишите способ доставки, домен для вебхука и secret_token для проверки, что запрос пришел именно от Telegram.
Бекенд на Laravel принимает вебхук в отдельном контроллере, проверяет заголовок с секретом и передает апдейт в обработчик сценария. Сервер защищают: firewall с доступом только к нужным портам, HTTPS через Let’s Encrypt, ограничение прав приложения к базе. Ответ на вебхук отдавайте быстро — тяжелые операции вроде запроса к LLM-API выносите в очередь, иначе Telegram повторит доставку по таймауту. Эти требования к инфраструктуре фиксируйте в ТЗ наравне с логикой диалогов.
- Наличие валидного TLS-сертификата (HTTPS) для безопасного шифрованного соединения.
- Открытые порты (443, 80, 88 или 8443) на стороне принимающего сервера.
- Настроенный
secret_tokenдля строгой верификации запросов от серверов мессенджера. - Асинхронная обработка тяжелых запросов (например, обращений к LLM) через систему очередей.
Автоматизация рабочих процессов с помощью внешних интеграций и API
Ценность бота растет, когда он не просто отвечает, а действует: создает заявку в CRM, проверяет статус заказа, записывает клиента, отправляет данные в HR-систему. Для этого бекенд бота обращается к внешним API по HTTP, а результат возвращает в диалог. Для корпоративного LLM-ассистента подключают RAG: перед ответом бот ищет релевантные фрагменты в базе знаний компании и передает их модели как контекст. Так ответы опираются на ваши документы, а не на догадки нейросети.
Каждую интеграцию в ТЗ описывайте отдельным блоком: какой сервис, какой метод API, какие поля передаются, что возвращается и как обрабатывается ошибка. Отдельно оговорите, где хранятся токены доступа и как ограничен объем данных, уходящих во внешний LLM-API. Для бота в Mattermost или на сайте эта схема повторяется — меняется только канал доставки, а слой интеграций и поиска по данным остается общим. Такой модульный подход позволяет менять каналы без переписывания бизнес-логики.
Стратегия тестирования и приемки: как проверить бота перед запуском в продакшен
Тестирование чат-бота проверяет три слоя: логику сценариев, качество генерации ответов и работу интеграций с каналами и данными. Для кнопочного Telegram-бота хватит прогона всех веток меню. Для LLM-ассистента этого мало: модель формулирует ответы каждый раз заново, поэтому один и тот же вопрос может дать разный результат. В ТЗ фиксируют критерии приемки: доля корректных ответов, время отклика, поведение на вопросах вне базы знаний. Дальше разберем три направления проверки — ручные прогоны по чек-листам, оценку релевантности генерации и мониторинг бота в рабочих контурах.
Успешный прогон кнопочных сценариев не гарантирует качества LLM-бота. Генеративные модели требуют регулярного тестирования на сотнях эталонных пар вопросов и ответов для контроля метрик релевантности.
Регулярное ручное тестирование сценариев и краевых случаев по чек-листам
Чек-лист собирают из реальных запросов пользователей и краевых случаев: пустое сообщение, опечатки, вопрос не по теме, попытка вытянуть из бота внутренние данные. Каждый пункт проходят вручную и фиксируют результат: ответ верный, частично верный, галлюцинация или отказ. Для Telegram отдельно проверяют команды, инлайн-кнопки, отправку файлов и работу в группах, где бот получает не все сообщения.
Ручные прогоны повторяют после каждого обновления промптов, базы знаний или версии LLM-API. Даже смена модели меняет тон и точность ответов. В ТЗ прописывают периодичность: перед релизом, после правок RAG-индекса и раз в спринт. Результаты сводят в таблицу, чтобы отслеживать регресс — когда исправление одного сценария ломает другой.
Контроль качества генерации текста и оценка метрик релевантности
Для LLM-бота ручных прогонов недостаточно — нужны числовые метрики. Собирают набор эталонных пар «вопрос — правильный ответ» на 100–300 примеров и прогоняют через бота. Считают долю ответов, где модель использовала данные из RAG, а не выдумала их. Отдельно измеряют groundedness — привязку ответа к источнику и точность извлечения нужного фрагмента из базы знаний.
Галлюцинации ловят так: если ответ содержит факт, которого нет в найденных документах, пример помечают как ошибку. Для оценки формулировок подключают вторую модель-судью или ручную выборочную проверку. В ТЗ задают пороги: например, не менее 90% ответов с опорой на источник и нулевая доля выдуманных цифр и реквизитов. Ниже порога бота в продакшен не выпускают.
Мониторинг работы бота в закрытых контурах компании и на профильных площадках
После запуска бота в корпоративном контуре — например, в Mattermost или во внутреннем веб-чате — логируют каждый диалог: вопрос, найденные документы, ответ и оценку пользователя. Логи хранят внутри периметра компании, чтобы переписка с сотрудниками не уходила во внешние сервисы. По ним считают долю запросов без ответа и находят пробелы в базе знаний.
Мониторинг настраивают на всплывающие проблемы: рост времени отклика, ошибки LLM-API, падение доли релевантных ответов. Настраивают алерты на аномалии и еженедельный разбор худших диалогов. Так ТЗ переходит из статуса «прототип за 30 минут» в надежное решение: бот дорабатывается по реальным данным, а бизнес видит, каким ответам можно доверять.