Чат-бот в Instagram не читает мысли и не становится умным сам по себе. Стандартный конструктор работает по сценариям: клиент нажимает кнопку — бот выдает заготовленный ответ. Как только человек задает вопрос своими словами, такой бот теряется. Чтобы он отвечал естественнее, подключают LLM — например, модели OpenAI. Но возникает проблема: нейросеть выдумывает факты, цены и условия, которых у вас нет. В этой статье разберем, как устроен умный бот в Instagram: из чего собирают стек, как работает архитектура RAG с базой знаний и почему правильная настройка убирает галлюцинации. Только рабочая механика.
- Умный бот в Instagram — это связка из 4 элементов: Instagram Graph API, конструктор сценариев, LLM-сервис (OpenAI) и база знаний. Без RAG (Retrieval-Augmented Generation) нейросеть выдумывает цены и условия; с RAG бот отвечает только по проверенным данным компании.
- Галлюцинации возникают, когда модели не задана база знаний и жесткие инструкции. Решение: подключить векторную базу данных (Pinecone, Qdrant), передавать модели только релевантные фрагменты и прописать правило — при отсутствии информации перенаправлять на менеджера.
- Безопасность достигается тремя механизмами: системные инструкции (запреты на домыслы), валидация ответов перед отправкой (фильтр по релевантности и триггеры эскалации), маскировка персональных данных перед отправкой во внешний LLM-сервис.
- Архитектура включает промежуточный сервер между Instagram и моделью, который принимает вебхук, ищет данные в индексе, формирует запрос и проверяет ответ перед отправкой клиенту — весь цикл занимает 2–5 секунд.
Больше чем магия: как на самом деле работают умные чат-боты в Instagram
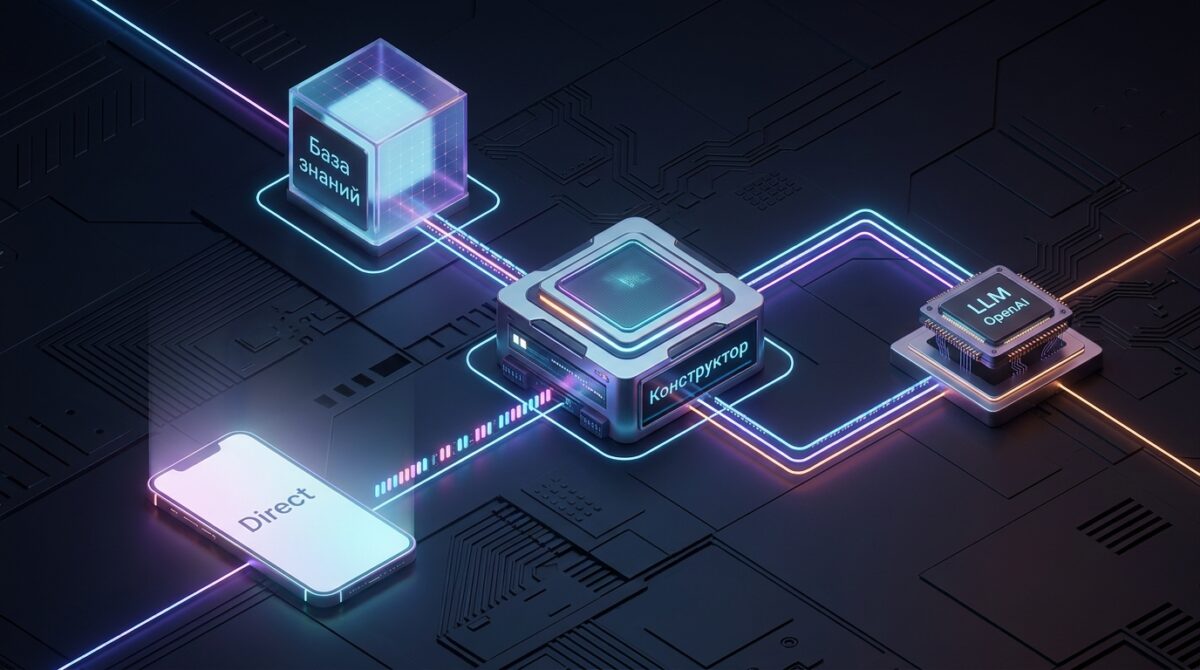
Умный бот для Instagram — это не одна программа, а связка из четырех элементов. Первый — Instagram Graph API, канал, через который сообщения из директа попадают в систему и уходят обратно. Второй — конструктор (Chatfuel, SendPulse, SMMBOT), где вы собираете сценарии и кнопки. Третий — LLM-сервис через API, который формулирует ответы человеческим языком. Четвертый — корпоративная база знаний, откуда бот берет реальные данные о ценах, товарах и условиях. Магии нет: клиент пишет вопрос, система находит нужный факт в вашей базе и передает его модели, а та превращает сухие данные в понятный ответ.
Жесткие сценарии против гибких LLM-агентов
Сценарный бот работает как дерево решений. Вы заранее прописываете каждую ветку: нажал кнопку «Цены» — получил прайс, выбрал «Доставка» — увидел условия. Клиент двигается по заготовленным маршрутам, и пока он жмет кнопки, все предсказуемо. Такой бот не ошибается в фактах, потому что не придумывает — он просто выдает то, что вы в него заложили. Минус в том, что человек не всегда хочет идти по кнопкам.
LLM-агент устроен иначе. Он читает вопрос целиком и формирует ответ на лету, даже если формулировка нестандартная. «А если я оплачу половину сейчас, а половину потом?» — сценарный бот такое не поймет, а LLM разберет смысл и ответит. Расплата за гибкость — риск выдумки. На практике два подхода совмещают: кнопки для типовых запросов и LLM для свободных вопросов.
| Критерий оценки | Сценарный бот (Кнопки) | LLM-агент (Нейросеть) |
|---|---|---|
| Принцип работы | Жесткое дерево решений и алгоритмы | Генерация текста на лету на основе контекста |
| Точность фактов | Абсолютная (выдает только заготовленное) | Высокий риск фантазий (если не внедрен RAG) |
| Понимание свободной речи | Низкое (реагирует только на точные команды) | Высокое (понимает скрытый смысл и опечатки) |
| Удержание контекста | Отсутствует (обрабатывает каждый шаг отдельно) | Отличное (помнит историю переписки) |
Почему обычные автоответчики теряются в контексте
Сценарный автоответчик не помнит, о чем шел разговор двумя сообщениями раньше. Каждое нажатие он обрабатывает изолированно. Клиент спрашивает про красную модель, затем пишет «а сколько она стоит?» — бот не понимает, к чему относится «она», и возвращает человека в главное меню. Диалог рассыпается, потому что у автоответчика нет памяти о предыдущих репликах внутри переписки.
LLM решает эту проблему за счет контекстного окна: модель получает не одно сообщение, а всю недавнюю переписку и понимает связи между репликами. Но окно ограничено по объему — слишком длинную историю приходится обрезать или сжимать. Из-за этого в настройке важно решить, сколько прошлых сообщений передавать модели: мало — потеряется контекст, много — вырастут задержка и стоимость запроса.
Причины, по которым нейросети начинают «галлюцинировать»
Галлюцинация — это когда модель уверенно выдает несуществующий факт: придумывает цену, обещает доставку за час или ссылается на акцию, которой нет. Причина в природе LLM: она не хранит данные о вашем бизнесе, а достраивает наиболее вероятное продолжение фразы. Если у модели нет доступа к реальным данным компании, она заполняет пробел правдоподобной выдумкой — и клиент получает ложное обещание.
[Иллюзия знаний]. Специалисты AiForSite отмечают, что главная причина галлюцинаций нейросетей в коммерческих чатах — это попытка языковой модели любой ценой ‘угодить’ клиенту и продолжить диалог при отсутствии жесткой привязки к корпоративным данным. Бот не врет намеренно, он просто достраивает наиболее вероятный текст из общих знаний.
Второй источник ошибок — расплывчатые инструкции. Когда боту не задали рамки, он отвечает на любые темы и импровизирует. Убирают галлюцинации двумя способами: подключают базу знаний через RAG, чтобы факты брались из проверенного источника, и прописывают строгие правила — отвечать только по данным компании, а при их отсутствии честно перенаправлять на менеджера.
🤖 ИИ-ассистент, который увеличивает конверсию
AiForSite — умный ИИ-помощник для вашего ресурса. Внедрите нейросеть за пару кликов, автоматизируйте общение с клиентами и собирайте лиды 24/7 без участия менеджера. Искусственный интеллект на ваш сайт!
Архитектура RAG: учим бота отвечать по вашей базе знаний
RAG (Retrieval-Augmented Generation) — это подход, при котором нейросеть отвечает не из своей памяти, а из вашей базы знаний. Работает так: перед тем как сгенерировать ответ, система ищет нужный фрагмент в документах компании — прайсе, условиях доставки, описании услуг — и передает его модели вместе с вопросом клиента. LLM формулирует ответ строго на основе найденного текста. Без RAG бот в директе фантазирует и придумывает цены. С RAG он опирается на факты, которые вы туда загрузили. Дальше разберем, как эта связка закрывает конкретные задачи бизнеса.
Как Retrieval-Augmented Generation решает бизнес-задачи
Клиент в Instagram спрашивает: «Есть ли скидка при заказе от трех штук?» Бот на чистой LLM без данных выдаст правдоподобную, но вымышленную цифру. Бот с RAG найдет в вашем документе пункт про оптовые условия и ответит точно: «При заказе от 3 штук — минус 10%». Ответ приходит из вашего источника, а не из общих знаний модели.
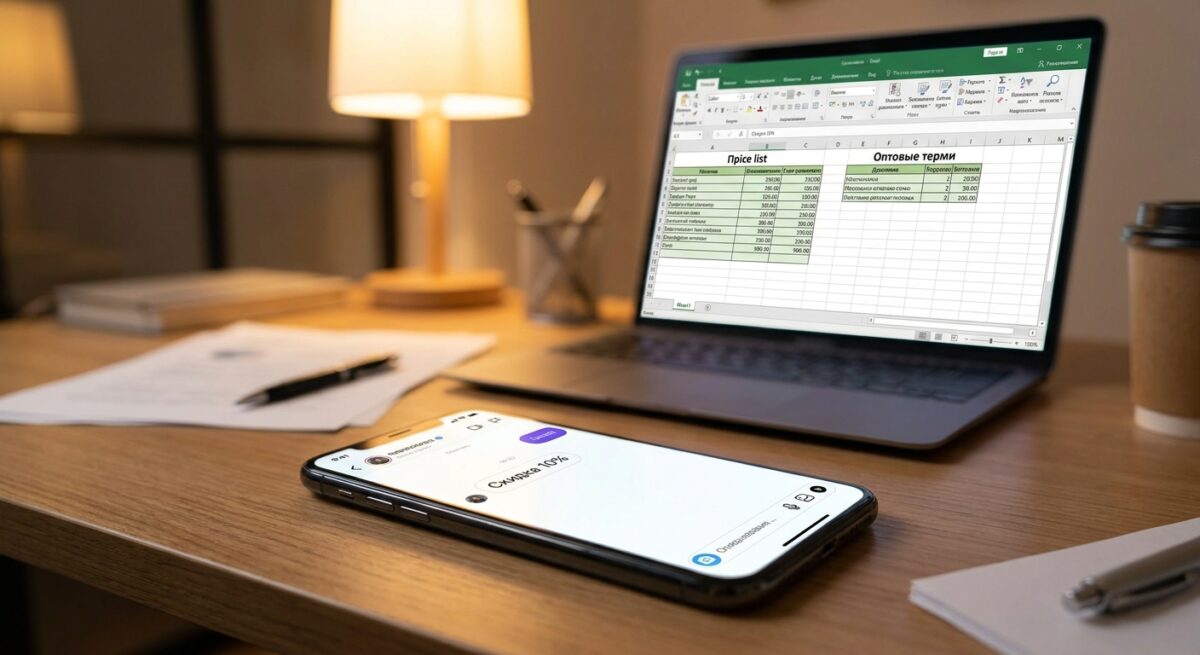
Так закрываются частые запросы: наличие товара, сроки доставки, гарантия, часы работы. Менеджер не отвечает на одни и те же вопросы сто раз, а подключается только к сложным случаям. При этом вы контролируете содержание: меняете прайс в базе — и бот сразу отвечает по новым цифрам, без переобучения модели и правок кода.
Путь сообщения: от Direct до осознанного ответа
Сообщение из директа проходит через несколько слоев. Сначала Instagram Graph API передает текст в конструктор — Chatfuel, SendPulse или аналог. Конструктор определяет: это сценарный запрос по кнопке или свободный вопрос. Если вопрос свободный, он уходит дальше — в LLM-слой через API.
Перед обращением к модели система прогоняет вопрос через поиск по базе знаний и подтягивает релевантные фрагменты. Затем LLM получает связку: вопрос клиента, найденные данные и жесткую инструкцию — «отвечай только по этим фактам, при нехватке информации переводи на менеджера». Модель формулирует ответ, конструктор возвращает его обратно в директ. Весь цикл занимает 2–5 секунд.
Векторные базы данных как память вашего бизнеса
Обычный текстовый поиск ищет по точному совпадению слов. Векторная база ищет по смыслу. Ваши документы разбивают на фрагменты и превращают в числовые векторы — эмбеддинги. Вопрос клиента тоже переводят в вектор, а затем система находит фрагменты, ближайшие по смыслу. Клиент напишет «сколько ждать посылку» — база найдет раздел о сроках доставки, даже если слова не совпадают.
Для хранения используют специализированные решения: Pinecone, Qdrant, Weaviate или расширение pgvector для PostgreSQL. Эта база и есть память вашего бизнеса: в ней лежат актуальные данные, к которым LLM получает доступ только через слой поиска. Модель не хранит ваши цены внутри себя — она берет их из индекса при каждом запросе. Обновили документ — бот сразу говорит правду.
Технический стек: связываем Instagram, конструкторы и LLM
Умный бот в Instagram — это не одна программа, а связка из четырех слоев. Первый: Instagram через официальный Graph API передает входящие сообщения и события. Второй: SaaS-конструктор (Chatfuel, SendPulse, SMMBOT) хранит сценарии, кнопки и логику диалога. Третий: LLM-сервис (OpenAI и аналоги) формулирует ответы живым языком. Четвертый: корпоративная база знаний, откуда модель берет факты о ценах, услугах и условиях. Каждый слой решает свою задачу — без любого из них бот либо молчит, либо выдумывает. Разберем, как эти части передают данные друг другу.
Чек-лист: 4 компонента для запуска нейробота
- Канал связи: Официальный Instagram API для легального приема и отправки сообщений.
- Логика и маршрутизация: Платформа-конструктор для настройки кнопок и перехвата событий.
- Мозг системы: Языковая модель (например, OpenAI) для генерации осмысленного текста.
- Хранилище фактов: Векторная база данных с актуальными прайсами и регламентами компании.
Как Instagram Graph API ловит события из Reels и Direct
Graph API — официальный способ получать данные из аккаунта. Когда клиент пишет в Direct или оставляет комментарий под Reels, Instagram отправляет вебхук: HTTP-запрос с текстом сообщения, ID пользователя и типом события. Ваш сервер подписывается на нужные события — messages для директа, comments для комментариев. Это работает только для бизнес-аккаунта или аккаунта автора, подключенного к странице Facebook.
У API есть жесткие ограничения. Ответить на сообщение из Direct можно в течение 24 часов после последнего действия пользователя — это стандартное окно Messenger Platform. Комментарии под Reels бот видит сразу, но массовые ответы Instagram модерирует и может ограничить при подозрении на спам. Поэтому события обрабатывают не напрямую в конструкторе — их сначала принимает промежуточный сервер.
Зачем в архитектуре нужен промежуточный сервер
Промежуточный сервер — это прослойка между Instagram и LLM. Он принимает вебхук от Graph API, достает текст вопроса, обращается к базе знаний, формирует запрос к модели OpenAI и возвращает готовый ответ в Direct. Без этого слоя невозможно контролировать, что уходит в нейросеть и что она отвечает клиенту.
Промежуточный сервер в архитектуре умного бота выполняет роль строгой ‘таможни’. Без него вы напрямую пускаете непредсказуемую языковую модель к вашим клиентам, теряя возможность отфильтровать запрещенные темы, скрыть коммерческую тайну или проверить адекватность ответа.
Сервер выполняет и защитную роль. Он проверяет ответ модели перед отправкой: убирает лишнее, подставляет проверенные цены, отсекает выдуманные обещания. Здесь же хранят ключи API, чтобы они не утекли, и логируют диалоги для разбора ошибок. Часть конструкторов вроде Chatfuel берет эту функцию на себя через встроенные интеграции — тогда отдельный сервер не нужен, но гибкости меньше.
Интеграция корпоративных знаний с моделями OpenAI
Модель OpenAI не знает ваших цен и услуг — ее обучали на общих данных из интернета. Если спросить бота о стоимости, он придумает цифру. Чтобы избежать этого, применяют подход RAG (retrieval-augmented generation): корпоративные данные — прайс, условия доставки, описания товаров — складывают в отдельный поисковый индекс. На вопрос клиента сервер сначала находит в индексе нужный фрагмент, потом передает его модели.
Дальше модель работает не по памяти, а по переданному тексту. В инструкции ей прямо задают рамку: отвечай только на основе предоставленных данных, при отсутствии информации переводи на менеджера. Такой строгий контекст и запрет на домыслы убирают основную причину галлюцинаций — бот перестает заполнять пробелы фантазией и оперирует фактами из вашей базы.
Безопасность и контроль: как свести риски к минимуму
Умный бот отвечает быстро, но за скорость платят контролем. LLM может уверенно назвать цену, которой нет в прайсе, пообещать доставку за час или сослаться на несуществующую акцию. Клиент воспримет это как официальную позицию компании и придет с претензией. Плюс вы передаете сообщения пользователей во внешний сервис, а значит отвечаете за их данные. Риски делятся на три группы: бот выдумывает факты, отвечает на то, где нужен человек, и утекают персональные данные. Каждую группу закрывают отдельным механизмом: системными инструкциями, валидацией ответов и правилами работы с данными. Разберем по порядку.
Системные инструкции: как ограничить фантазию бота
Системный промпт — это набор правил, который бот получает перед каждым диалогом и не показывает клиенту. В нем прописывают роль, границы и запреты: отвечать только по базе знаний, не называть цены из головы, не обещать сроков, которых нет в документах. Ключевая формулировка — «если информации нет в предоставленном контексте, скажи, что уточнишь у менеджера». Она превращает «я не знаю» из ошибки в штатный сценарий.
Одних запретов мало — работает связка инструкции с RAG. Бот получает не всю базу, а только фрагменты, релевантные вопросу, и отвечает строго по ним. Так вы отрезаете модель от «общих знаний», где и рождаются выдумки. В инструкции добавляют формат ответа: коротко, по делу, без домыслов. Чем жестче рамки, тем предсказуемее бот в директе и комментариях под Reels.
Валидация ответов: когда пора звать человека
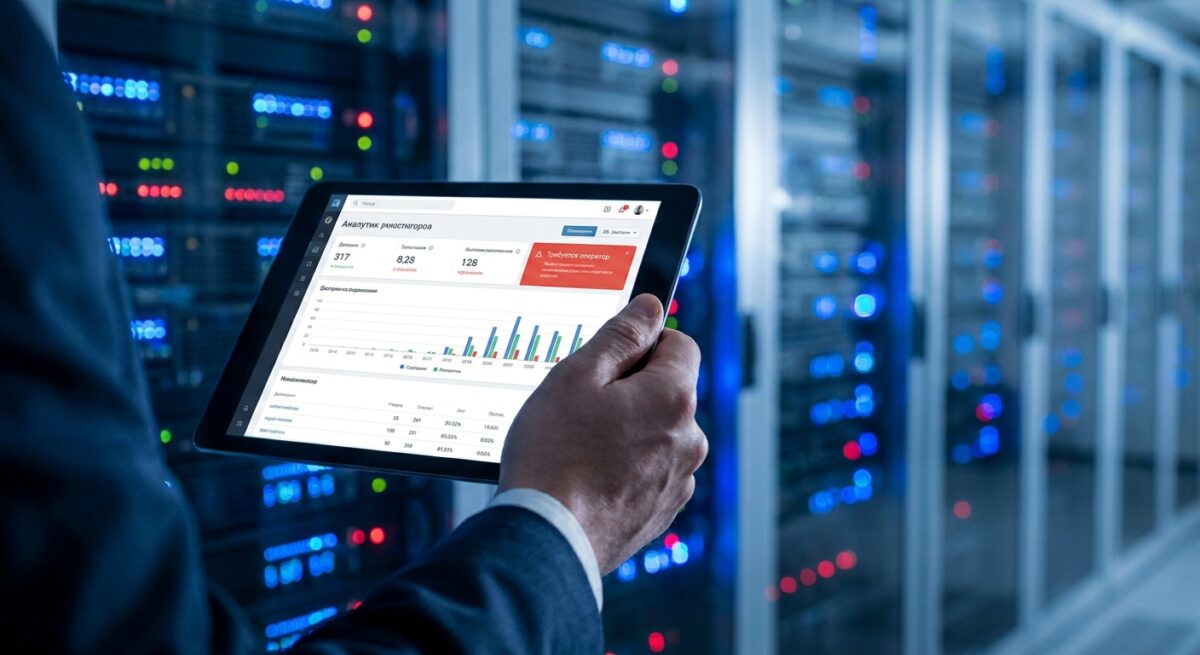
Даже с жесткими инструкциями бот не должен вести все диалоги до конца. Валидация — это фильтр между ответом модели и отправкой клиенту. Она проверяет: нашлись ли данные в базе, уверен ли бот, не касается ли вопрос денег, договора или жалобы. Если проверка не пройдена, ответ не уходит автоматически — диалог передается менеджеру. Технически это реализуют через оценку релевантности найденных фрагментов и стоп-слова вроде «вернуть», «жалоба», «суд».
Передавать человеку нужно и по эмоциям, и по деньгам. Заявка на крупную сумму, недовольный клиент, нестандартный запрос — все это триггеры для эскалации. Хороший сценарий: бот закрывает типовые вопросы о наличии, часах работы и доставке, а сложное отдает оператору с уже собранным контекстом переписки. Так вы получаете скорость на потоке и живого человека там, где ошибка бота стоит денег или репутации.
Эффективный ИИ в бизнесе не заменяет человека полностью, а берет на себя первичную рутину. Настоящая автоматизация настраивается так, чтобы любой конфликт, жалоба или нестандартный запрос мгновенно переводились на живого менеджера до того, как бот совершит критическую ошибку.
Как защитить данные при работе с внешними LLM
Отправляя сообщение клиента в OpenAI или аналог, вы передаете данные на чужой сервер. Первое правило — не грузить в промпт лишнее: номера карт, паспорта, полные адреса. Персональные данные маскируют или заменяют плейсхолдерами до обращения к модели. Базу знаний тоже чистят: во внешний индекс попадают публичные сведения о товарах и услугах, а не внутренние документы и клиентские таблицы.
Второй слой защиты — выбор режима работы провайдера. У OpenAI данные из API по умолчанию не используются для обучения, но это стоит проверять в условиях сервиса и настройках. Для чувствительных ниш выбирают провайдеров с хранением в нужной юрисдикции или разворачивают модель локально. Обязательно предупреждайте пользователя в директе, что общается с ботом и данные обрабатываются, — это требование площадки и закона о персональных данных.