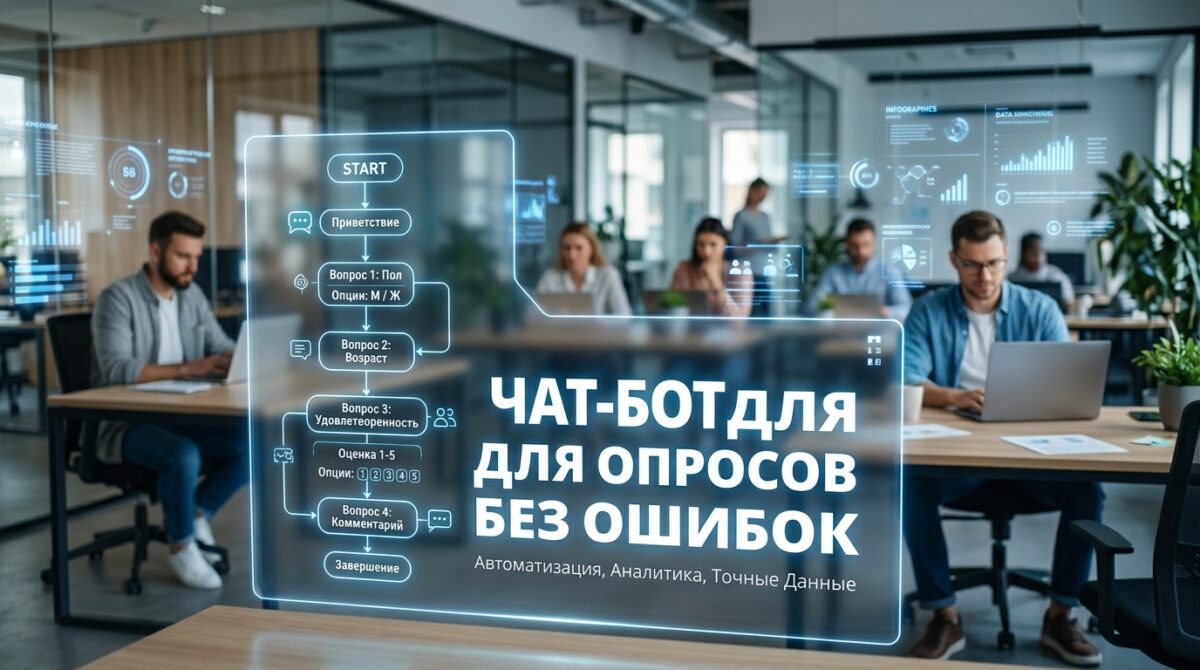
Чат-бот опросник не обязан ничего выдумывать. Его задача — вести человека по анкете, записывать ответы и передавать их в CRM, а не сочинять данные за пользователя. Распространен миф: бот на LLM обязательно начнет галлюцинировать или потребует дорогой разработки с нуля. На деле опросник строится как жесткий сценарий, где нейросеть отвечает только за формулировки и уточняющие вопросы. Ниже разберем, как устроен такой чат: как связать сценарий, RAG и валидацию ответов, чтобы бот работал точно и безопасно с корпоративными данными. Это не магия, а инженерия — и ее можно повторить.
- Чат-бот-опросник не галлюцинирует: LLM работает только внутри жесткого сценария (конечного автомата), а оркестратор контролирует логику вопросов и порядок переходов между шагами
- Трехуровневая защита данных: валидация формата (код), семантическая проверка ответов (LLM), RAG для встречных вопросов — бот отвечает только на основе корпоративной базы знаний, без выдумок
- Интеграция с CRM полностью автоматизирована: ответы пишутся структурированно в базу данных, аналитика считается в реальном времени, триггеры запускают действия команды (задачи менеджерам, обращения в поддержку)
Анатомия бизнес-анкеты: как заставить LLM проходить сценарий без галлюцинаций
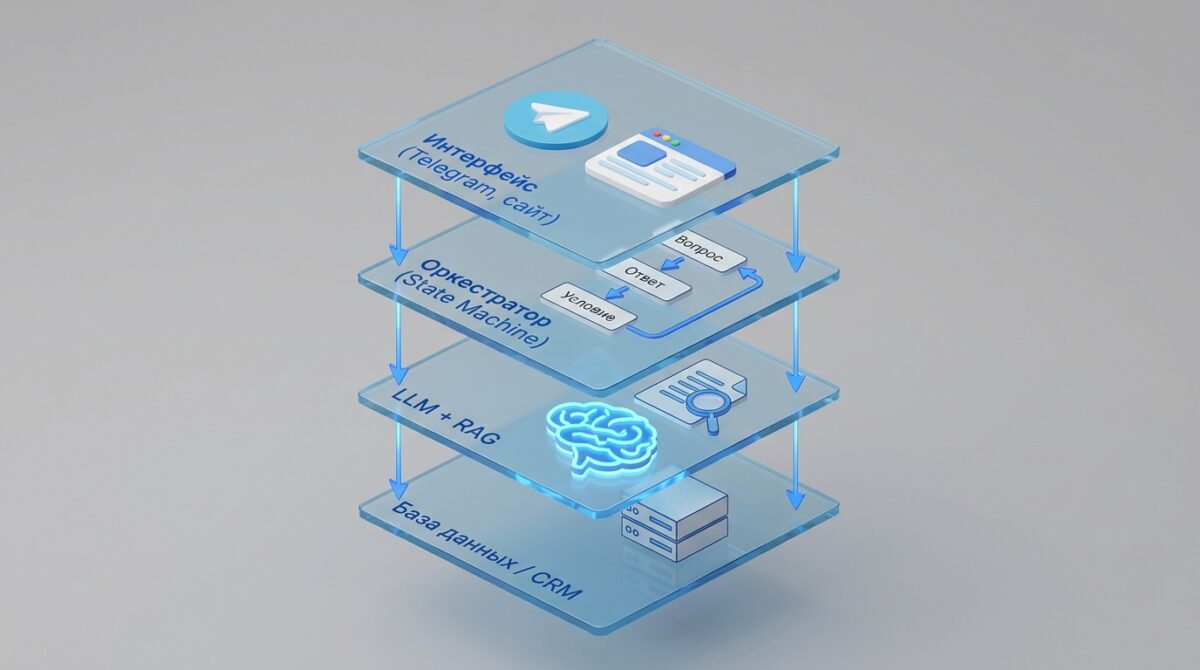
Бот-опросник состоит из четырех слоев: интерфейс (Telegram, виджет на сайте, мессенджер), оркестратор сценария, LLM и хранилище ответов. Ключевую роль играет оркестратор — он держит порядок вопросов, а не нейросеть. LLM подключают точечно: переформулировать вопрос под контекст, задать уточнение, распознать смысл свободного ответа. Данные пишутся в базу структурированно, поэтому придумать чего-то бот не может — каждое поле анкеты жестко привязано к переменной. Дальше разберем три механизма, которые удерживают LLM в рамках: гибридный workflow, RAG и валидацию ввода.
Гибридная архитектура: почему жесткий workflow эффективнее чистой генерации
Чистая генерация — когда бот сам решает, что спросить дальше — ломает анкету. LLM теряет нить после 10–15 реплик, пропускает вопросы, меняет порядок. Для NPS или ESG-опроса это недопустимо: аналитика требует одинаковых полей у всех респондентов. Поэтому логику ведет конечный автомат (state machine): шаг 1 — вопрос о возрасте, шаг 2 — оценка сервиса, шаг 3 — комментарий. Переход между шагами контролирует код, а не модель.
LLM в этой схеме работает внутри одного шага. Она принимает сырой ответ человека, извлекает нужное значение и возвращает его оркестратору. Например, на фразу «ну так, средненько» модель ставит оценку 3 из 5 и просит подтвердить. Сценарий остается предсказуемым, а диалог — живым. Так бизнес получает и точность формы, и гибкость общения, не жертвуя ни тем, ни другим.
Механика RAG и контекстные ограничения для защиты корпоративных данных
RAG (retrieval-augmented generation) подключают, когда бот должен отвечать на встречные вопросы респондента: «что входит в тариф?», «как вы храните мои данные?». Вместо того чтобы дать LLM выдумать ответ, система ищет фрагмент в базе знаний компании и передает его модели как контекст. Модель формулирует ответ строго по найденному тексту. Нет фрагмента — бот отвечает «уточню у специалиста», а не сочиняет.
Использование RAG — это не просто улучшение, а фундаментальный принцип безопасности. По опыту компании AiForSite, он превращает потенциально ‘креативную’ LLM в надежного ассистента, который отвечает на вопросы клиентов исключительно на основе проверенных корпоративных данных, полностью исключая риск дезинформации.
Контекстные ограничения защищают корпоративные данные. LLM видит только тот кусок базы, который релевантен вопросу, и не имеет доступа к CRM, персональным данным других клиентов или внутренним документам без прав. Роли и права настраивают на уровне оркестратора: анкета собирает ответы, но модель их не читает целиком и никуда не отправляет. Так критичная информация остается внутри контура, а генеративный слой работает только с публичной базой знаний.
Валидация ответов: как отсеять некорректный ввод на лету
Валидация проверяет ответ до записи в базу. Простые случаи закрывает код: телефон — по маске, email — по формату, оценка — в диапазоне от 1 до 10. Если человек в поле «возраст» пишет «много», система не пропускает значение и переспрашивает. Эти правила работают без LLM и стоят на первой линии — они дешевле и надежнее любой модели.
LLM подключают к валидации там, где ответ свободный. Модель определяет, относится ли реплика к заданному вопросу: на «оцените доставку» ответ «а где мой заказ?» она распознает как уход в сторону и мягко возвращает к теме. Двойной контроль — жесткие правила плюс семантическая проверка — отсекает мусор на лету. В базу попадают только чистые, структурированные данные, готовые к аналитике без ручной чистки.
| Тип валидации | Инструмент | Пример применения |
|---|---|---|
| Формальная (простая) | Код (регулярные выражения, маски) | Проверка формата email, номера телефона, числового диапазона (оценка от 1 до 10). |
| Семантическая (сложная) | LLM (нейросеть) | Анализ смысла ответа: относится ли комментарий к вопросу о доставке или это уход от темы. |
🤖 ИИ-ассистент, который увеличивает конверсию
AiForSite — умный ИИ-помощник для вашего ресурса. Внедрите нейросеть за пару кликов, автоматизируйте общение с клиентами и собирайте лиды 24/7 без участия менеджера. Искусственный интеллект на ваш сайт!
Проектирование и интеграция: пошаговый запуск безопасного чат-бота для обратной связи
Запуск чат-бота опросника состоит из четырех шагов: собрать сценарий анкеты, подготовить базу знаний, подключить LLM как движок диалога и связать бота с CRM. Сценарий фиксирует список вопросов и логику переходов — LLM не выбирает, что спросить дальше, а оркестратор ведет пользователя по заранее заданному workflow. База знаний через RAG подставляет факты о компании, чтобы бот не выдумывал ответы на уточняющие вопросы. Валидация проверяет ответы на формат перед записью. Такая схема убирает главный риск — галлюцинации — и делает результат предсказуемым. Разберем каждый блок по порядку.
Подготовка базы знаний и сценариев под конкретные задачи компании
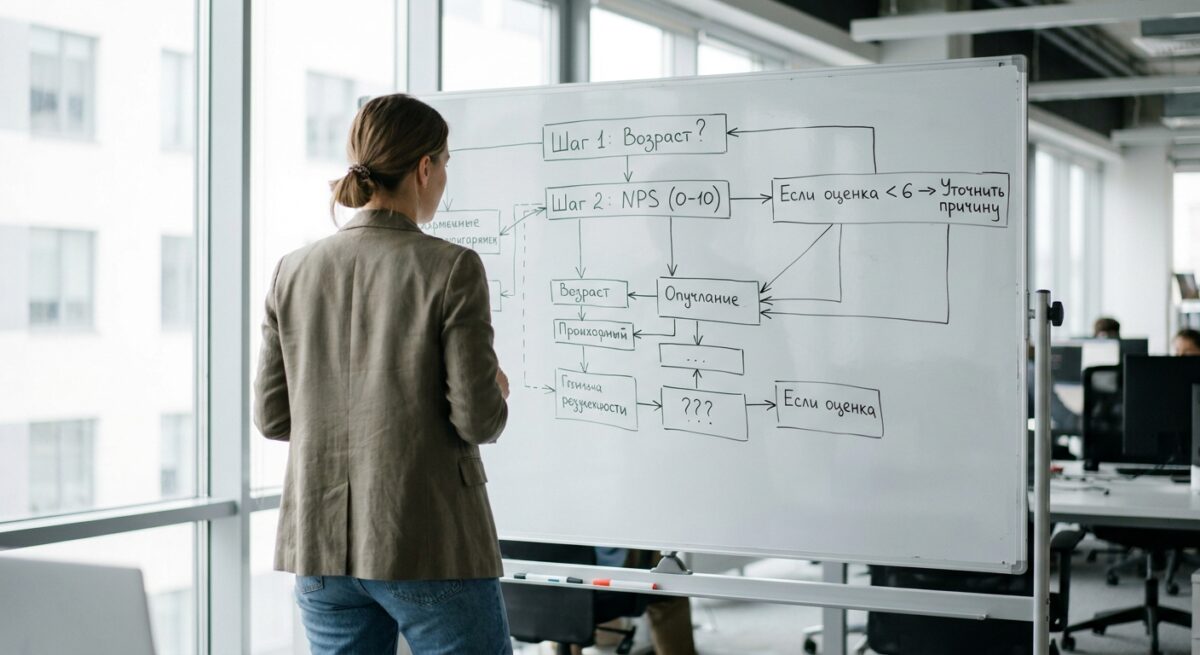
Сценарий опроса описывают как строгий workflow: вопрос, тип ответа, условие перехода. Для NPS хватит шкалы от 0 до 10 и одного открытого поля. Для опроса сотрудников добавляют ветвления: недовольный ответ ведет к уточнению причины. LLM здесь переформулирует сухой вопрос под тон компании и разбирает свободные ответы, но не меняет структуру анкеты. Границы задают в промпте: бот не отвечает на вопросы вне темы опроса.
База знаний нужна, когда пользователь задает встречный вопрос — про сроки, продукт или условия. Вместо выдумки бот через RAG достает ответ из загруженных документов: регламентов, FAQ, описаний услуг. Данные разбивают на фрагменты и индексируют, чтобы модель отвечала только на основе найденного текста. Если ответа в базе нет, бот честно сообщает об этом и возвращает пользователя к анкете. Это отделяет проверенные факты от генерации.
Интеграция с CRM и автоматическая аналитика собранных анкет
Ответы бот пишет не в чат, а в структурированное хранилище: базу данных или напрямую в CRM через API. Каждый ответ привязывают к полю анкеты и к профилю клиента или сотрудника. Оркестратор передает данные после валидации — если ответ не прошел проверку формата, запись не создается. Роли и права ограничивают доступ: LLM видит только текущий диалог, а критичные поля CRM обновляет сервер, а не модель. Так корпоративные данные остаются под контролем.
- API-соединение с CRM: Убедитесь, что бот может надежно отправлять и получать данные.
- Маппинг полей: Каждый ответ из анкеты должен быть связан с конкретным полем в базе данных или карточке клиента.
- Валидация на входе: Внедрите проверку данных (формат, диапазон) перед отправкой в CRM, чтобы избежать ‘грязных’ записей.
- Разграничение прав: Настройте доступы так, чтобы LLM не имела прямого доступа к базе клиентов.
- Настройка триггеров: Создайте автоматические действия (например, задача менеджеру при низкой оценке) для мгновенной реакции на обратную связь.
Собранные анкеты сразу уходят в аналитику. NPS считается автоматически, открытые ответы группируются по темам, а тональность размечает та же LLM. Дашборд показывает динамику по дням и сегментам без ручного переноса из таблиц. Триггеры запускают действия: низкая оценка создает задачу менеджеру, жалоба уходит в поддержку. Опрос перестает быть разовым сбором данных и встраивается в рабочие процессы — от первого сообщения до реакции команды.