HR-чат-бот на LLM ломается не потому, что модель плохая, а потому что ее подключили к базе кандидатов без ограничений и контроля. В итоге бот выдумывает вакансии, путает регламенты по отпускам и вытягивает лишние персональные данные. Разберем, как устроен рабочий чат-бот для рекрутинга и внутренних HR-запросов: почему одного дообучения на базе компании мало, как RAG подтягивает знания из ваших документов без галлюцинаций, зачем нужен закрытый контур для ПДн и в какой момент диалог должен перейти живому рекрутеру. Только архитектура, схемы контроля и понятный план внедрения от пилота до реальных сценариев.
- HR-боты на LLM требуют архитектуры с четырьмя слоями: языковая модель, база знаний (RAG), разграничение доступа и правила эскалации к человеку — простого дообучения на данных компании недостаточно
- RAG (retrieval-augmented generation) решает проблему галлюцинаций: бот отвечает только на основе найденных фрагментов актуальных документов, а не из памяти модели, что позволяет обновлять регламенты без переобучения
- Безопасность закладывается в архитектуру: закрытый контур для ПДн, анонимизация данных перед отправкой в модель, разграничение доступа по ролям и обязательная эскалация сложных случаев к живому HR с полным логированием диалогов
- Внедрение начинают с узкого пилота на одном сценарии с низким риском (FAQ по кадрам), проверяют каждый диалог, обновляют документы в базе знаний, а затем масштабируют только после стабильных результатов
HR-боты на базе LLM: почему это больше не просто чат
Разница между старым чат-ботом и решением на LLM — в способе получения ответа. Скриптовый бот выбирает готовую фразу из заранее прописанного дерева: не совпал вопрос с шаблоном — кандидат упирается в тупик. LLM-бот генерирует ответ на основе смысла запроса и данных из ваших документов, поэтому понимает формулировки вроде «а сколько дней отпуска мне положено после года работы» без точного совпадения ключевых слов. Но именно эта свобода создает риск: без ограничений и подключения к реальной базе знаний модель начинает придумывать факты. Дальше разберем, откуда взялась эта разница и что она меняет для рекрутера.
Эволюция инструментов: от жестких скриптов к живому общению
Скриптовые боты работали по схеме «кнопка — заготовленный ответ». HR прописывал ветки диалога вручную: вопрос про график — ответ №14, вопрос про больничный — ответ №22. Любое отклонение от сценария ломало логику, и сотрудник получал «Я вас не понял» или переключение на оператора. Поддерживать такое дерево на сотни тем дорого: каждое изменение регламента требовало ручной правки десятков веток.
Жесткие скрипты окончательно уходят в прошлое. Современный кандидат не хочет общаться с бездушным деревом кнопок — ему нужен осмысленный диалог, где система понимает контекст, помнит предыдущие реплики и отвечает человеческим языком.
LLM убирает жесткое дерево. Модель разбирает смысл вопроса и строит ответ из подключенных источников, а не из списка заготовок. Кандидат пишет свободным языком, бот отвечает по существу и удерживает контекст диалога — помнит, что спрашивали абзацем выше. Это переход от «поиска по шаблону» к общению. Но живость ответа не означает, что бот сам знает правила компании: знания в него нужно загрузить отдельно, и об этом — в следующем блоке.
Зачем HR-у нейросети: персонализация и масштаб без потери качества
Главная выгода — обработка потока запросов без роста штата. Один бот отвечает сотне кандидатов одновременно в любое время суток: рассказывает про этапы отбора, статус заявки, условия оформления. Рекрутер разгружается от повторяющихся вопросов и занимается собеседованиями и оценкой. Для внутренних HR-запросов та же логика: бот закрывает типовые обращения по отпускам, справкам и кадровым процедурам, а не отвлекает специалиста на каждое «где взять справку 2-НДФЛ».
Персонализация появляется за счет доступа к данным конкретного человека. Бот подставляет в ответ индивидуальные вводные: остаток отпуска сотрудника, этап, на котором находится заявка кандидата, его отдел и должность. Ответ перестает быть общей выпиской из регламента и становится адресным. Ключевое условие — бот берет эти данные из проверенного источника с разграничением доступа, а не выдумывает. Именно поэтому «просто дообучить модель» не решает задачу, что и разберем ниже.
Мифы о простоте: почему «дообучить» бота недостаточно
Расхожая идея — «загрузим базу компании в модель, и она все выучит». На практике массово используют не обучение с нуля, а связку из двух частей: безопасную донастройку поведения плюс retrieval (RAG) — подтягивание нужных фрагментов из внутренних документов в момент ответа. Обучать модель на сырых переписках рискованно: она запоминает данные вперемешку, путает актуальные и устаревшие правила, а обновить одно положение регламента без переобучения нельзя.
RAG решает это иначе: знания лежат в отдельной базе, бот ищет в ней подходящий кусок и отвечает строго по нему. Поменялся регламент по отпускам — обновили документ, и бот сразу отвечает по новой версии, без переобучения. Так снимается и риск галлюцинаций: модель опирается на конкретный источник, а не на память. Но подключить документы мало — нужны разграничение доступа, закрытый контур для персональных данных и передача сложных случаев человеку. Как собрать эту архитектуру — в следующих разделах.
🤖 ИИ-ассистент, который увеличивает конверсию
AiForSite — умный ИИ-помощник для вашего ресурса. Внедрите нейросеть за пару кликов, автоматизируйте общение с клиентами и собирайте лиды 24/7 без участия менеджера. Искусственный интеллект на ваш сайт!
Внутренняя кухня: как устроены умные HR-ассистенты
HR-бот на LLM состоит из четырех слоев: языковая модель как ядро, база знаний компании, слой поиска по этой базе (RAG) и правила поведения — роли, доступы, стоп-слова, эскалация к человеку. Модель сама по себе не знает ваших регламентов и вакансий, она умеет только формулировать текст. Знания приходят из подключенных документов, а не из «памяти» нейросети. Такая архитектура нужна, чтобы бот отвечал по фактам из ваших источников, а не придумывал. Дальше разберем каждый элемент: где держать модель, как подключить документы, стоит ли донастраивать модель и как связать бота с рабочими системами HR.
- Языковая модель (LLM): Ядро системы, которое отвечает за понимание смысла запроса и генерацию связного, естественного текста.
- Корпоративная база знаний: Хранилище актуальных регламентов, памяток, политик компании и детальных описаний вакансий.
- Слой поиска (RAG): Механизм, который в реальном времени извлекает нужные факты из базы и передает их нейросети для формирования ответа.
- Система безопасности: Настройки ролей, доступов, анонимизация ПДн и жесткие правила передачи диалога живому HR-специалисту.
Выбор «мозга» для бота: облака против собственных серверов
Облачные модели (OpenAI, Anthropic) дают высокое качество ответов и запуск за дни, без закупки серверов. Минус — данные уходят к провайдеру, поэтому персональные данные кандидатов и сотрудников нужно анонимизировать до отправки или использовать корпоративные тарифы с гарантией, что запросы не идут на обучение модели. Для FAQ по кадрам и онбордингу этого варианта чаще достаточно.
Локальные модели на своих серверах держат данные внутри контура — это критично, если бот работает с зарплатами, медсправками, оценками. Плата за это — слабее качество ответов у открытых моделей и расходы на GPU и поддержку. На практике выбор зависит от чувствительности данных в сценарии: чем ближе бот к необработанным ПДн, тем весомее аргумент за свой контур.
Магия RAG: как научить нейросеть работать с документами компании
RAG (retrieval-augmented generation) решает главную проблему — галлюцинации. Механика простая: вопрос сотрудника превращается в поисковый запрос по базе регламентов, система находит нужные фрагменты (например, пункт о переносе отпуска) и передает их модели вместе с вопросом. Модель отвечает строго по этим фрагментам, а не по абстрактным знаниям из интернета. Ответ можно сопроводить ссылкой на документ-источник.
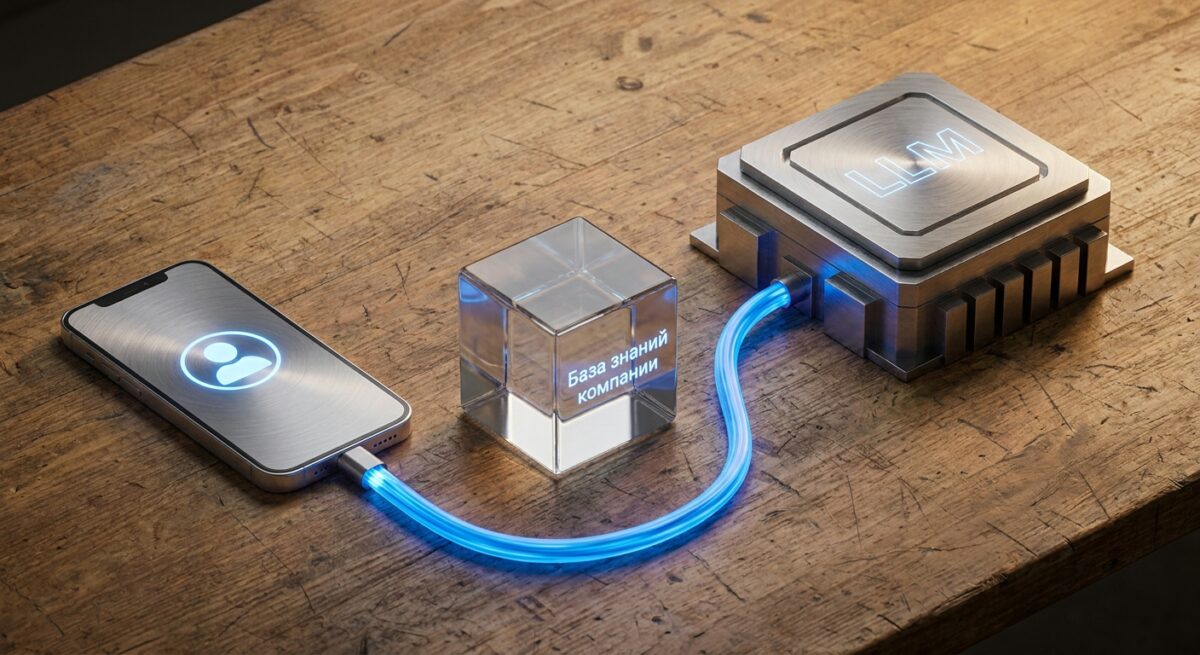
Это развеивает миф про «обучение на базе компании». Модель не переучивают — ей на лету подсовывают актуальные куски знаний. Обновили положение об отпусках — загрузили новый файл, и бот сразу отвечает по нему, без переобучения. Здесь же настраивают разграничение доступа: RAG ищет только по тем документам, которые разрешены роли конкретного пользователя, поэтому рядовой сотрудник не получит данные из зоны руководителя.
Тонкая настройка: как адаптировать модель без лишнего риска
Донастройка (fine-tuning) отвечает не за знания, а за манеру: тон общения, формат ответов, узнавание корпоративных сокращений и типовых формулировок вакансий. Обучать модель с нуля в HR не нужно и опасно — это дорого и легко ведет к тому, что бот начинает выдавать заученные обрывки чужих переписок как факт. Знания оставляют на стороне RAG, а fine-tuning применяют точечно и только на очищенных данных.
Отдельный риск — дообучение на сырых логах диалогов. В переписках есть имена, телефоны, детали кандидатов, и они утекут в веса модели, откуда их не удалить выборочно. Безопасный путь: анонимизировать данные перед любой настройкой, а поведение бота корректировать в основном через системный промпт и правила, а не через переобучение. Так проще откатить изменения и объяснить, почему бот ответил именно так.
Связываем все воедино: интеграция с ATS, CRM и корпоративными базами
Чтобы бот-рекрутер работал, его подключают к ATS: он читает статусы кандидатов, вакансии, этапы воронки и может отвечать соискателю, на какой стадии его заявка. Внутренний HR-бот связывают с кадровой системой и порталом регламентов, чтобы отвечать про остатки отпуска или порядок оформления больничного. Интеграцию делают через API с ограниченными правами: бот получает только те поля, что нужны сценарию.
Главная ошибка при внедрении — доверить нейросети доступ ко всем системам сразу. По опыту компании AiForSite, надежная интеграция строится исключительно через жестко ограниченный API, где бот получает только те данные, которые необходимы для ответа на конкретный вопрос пользователя.
Каждое обращение бота к системам журналируют — кто, что спросил и какие данные подтянулись. Это дает контроль над утечками и позволяет разбирать ошибки. Если бот не нашел ответ в базе или запрос попал на стоп-слово (увольнение, конфликт, жалоба), диалог автоматически уходит живому HR. Такая связка API + логи + эскалация превращает бота из «черного ящика» в управляемый инструмент с предсказуемым поведением.
Безопасность и право: как не превратить помощника в проблему
HR-бот работает с самыми чувствительными данными компании: резюме, зарплатами, медицинскими справками, причинами увольнений. Один неверный запрос — и модель выдает данные одного сотрудника другому или отправляет резюме кандидата во внешний сервис. Обработка таких сведений подпадает под требования по защите персональных данных: нужны согласие субъекта, ограничение целей обработки и контроль, куда уходит информация. Поэтому безопасность закладывают в архитектуру до запуска, а не чинят после утечки. Ниже разберем три опоры надежного бота: защищенное хранение данных, механизмы против выдумок и правила передачи сложных случаев человеку.
Защита данных: приватность, анонимность и закрытый контур
Первое решение — закрытый контур. Данные HR-базы и регламенты хранят внутри инфраструктуры компании или в изолированном облачном сегменте, а модель обращается к ним через контролируемый канал. При работе с внешними LLM выбирают режим, где провайдер не использует запросы для обучения. Для локальных решений весь трафик остается в периметре организации. Так резюме и зарплатные данные не попадают в открытый интернет.
Второй слой — анонимизация и разграничение доступа. Перед отправкой в модель из текста вырезают прямые идентификаторы: ФИО, телефоны, номера документов заменяют на метки. Роли решают, что доступно: рекрутер видит воронку кандидатов, рядовой сотрудник — только регламенты по отпускам и справкам. Бот подтягивает через RAG лишь те документы, к которым у пользователя есть право, а не всю базу целиком.
| Где развернута LLM | Ключевые преимущества для HR | Главные риски и ограничения | Защита персональных данных (ПДн) |
|---|---|---|---|
| Облачные сервисы (OpenAI, Anthropic) | Быстрый запуск, высочайшее качество ответов, не требуются мощности собственных серверов | Зависимость от стороннего вендора, риск передачи чувствительной информации наружу | Требуется обязательная и строгая анонимизация всех данных до отправки запроса |
| Локальные модели (Собственные серверы) | Полный контроль над инфраструктурой, возможность легальной работы с зарплатами и медсправками | Высокие капитальные затраты на GPU-серверы, сложная поддержка, качество генерации может уступать облакам | Максимальная (данные физически не покидают закрытый контур компании) |
Борьба с галлюцинациями: как заставить бота говорить только правду
LLM склонна доверчиво достраивать ответ, даже когда фактов нет. В HR это опасно: бот придумает несуществующий пункт трудового договора или неверную сумму компенсации. Основа защиты — RAG: модель отвечает не из памяти, а на основе найденных фрагментов ваших документов, и в ответе указывает источник. Если релевантный документ не нашелся, бот обязан сказать «данных нет», а не сочинять. Это правило прописывают в системном промпте.
Дополнительно ставят фильтры и стоп-слова: на вопросы о зарплате коллег, юридические трактовки увольнения или медицинские темы бот не отвечает сам, а передает запрос дальше. Ответы регулярно сверяют с актуальными регламентами — устаревший документ в базе рождает верную по форме, но неправильную по сути реплику. Знания обновляют через замену документов в RAG, а не бесконтрольным дообучением на сырых переписках.
Когда нужен человек: правила эскалации и контроль диалогов
Бот закрывает типовые вопросы, но должен вовремя отдавать сложное живому HR. Триггеры эскалации задают заранее: конфликтная формулировка, тема увольнения или дискриминации, повторный вопрос без решения, прямая просьба «дайте человека». При срабатывании бот не импровизирует, а переключает диалог на рекрутера или кадрового специалиста с сохранением контекста, чтобы человек не переспрашивал заново.
Искусственный интеллект не способен заменить базовую эмпатию. Как только в диалоге возникает конфликтная ситуация, жалоба или нестандартная просьба, система должна мгновенно передать весь контекст беседы живому HR-специалисту.
Контроль качества строят на журналировании. Каждый диалог логируется: запрос, найденные источники, ответ и факт эскалации. Раз в неделю выборку проверяют — ищут выдумки, ошибочные регламенты и частые темы, где бот пасует. По итогам правят промпты, обновляют документы в базе и уточняют триггеры. Так помощник остается предсказуемым: рекрутер видит, откуда взят каждый ответ, и держит систему под контролем.
На практике: как внедрить бота и не провалиться
Провал внедрения обычно наступает на одном из трех этапов: базу знаний скормили боту как есть, доступ к данным не разграничили, а тестировать сценарии начали сразу на живых кандидатах. Рабочий подход обратный. Сначала выбирают конкретный процесс с высокой нагрузкой и низкой ценой ошибки — например, ответы на типовые вопросы по кадрам. Затем подключают LLM-платформу к внутренним регламентам через RAG, ограничивают контекст и роли, прогоняют диалоги в тесте под контролем рекрутеров. Дальше разберем два самых частых сценария и порядок запуска, который не приводит к утечкам и галлюцинациям.
Рекрутинг на автопилоте: от скрининга до ответов кандидатам
Бот-рекрутер закрывает первый контакт с кандидатом: отвечает на вопросы о вакансии, условиях и этапах отбора, собирает базовые ответы по требованиям и назначает время созвона. Знания о вакансиях он берет не из головы, а из актуального описания через RAG, поэтому не выдумывает зарплатную вилку и не обещает удаленку, которой нет. Скрининг сводится к структурированным вопросам с четкими критериями, а спорные ответы бот не оценивает сам.
Решение по кандидату остается за человеком. Бот готовит саммари диалога и передает его рекрутеру, а нестандартные ситуации — встречный вопрос об условиях, жалоба, агрессия — уводит на живого сотрудника по стоп-словам. Каждый диалог журналируется, чтобы можно было проверить, что и на каком основании ответила модель. Это снимает риск, что кандидат получит некорректное обещание, а компания — репутационную претензию.
Личный ассистент сотрудника: онбординг и ответы на вопросы 24/7
Внутренний бот отвечает на кадровые вопросы: как оформить отпуск, где взять справку 2-НДФЛ, сколько дней осталось по больничному, какие документы нужны новичку в первую неделю. Ответы он формирует из корпоративных регламентов и инструкций через RAG, а не из общих знаний модели, поэтому не путает вашу политику отпусков с абстрактной. Для онбординга бот ведет нового сотрудника по чек-листу: доступы, обучение, знакомство с командой.
Разграничение доступа здесь критично. Рядовой сотрудник видит только свои данные и общие регламенты, а зарплаты коллег или личные дела остаются недоступны — роль в системе определяет, что бот вправе показать. Данные хранятся в защищенном контуре, персональные сведения анонимизируются там, где это возможно. Если вопрос выходит за рамки регламентов или касается спорной выплаты, бот переключает сотрудника на HR-специалиста вместо того, чтобы додумывать ответ.
Дорожная карта внедрения: от пилота до реальной пользы
Начинают с одного узкого сценария и небольшой группы пользователей. На пилоте подключают RAG к выверенной части документов, настраивают роли, стоп-слова и правило эскалации к человеку. Диалоги в этот период читают рекрутеры: отмечают, где бот ошибся, где ответил не по регламенту, где стоило передать вопрос человеку. По этим правкам обновляют базу знаний и промпты — именно обновление документов, а не дообучение модели на сырых переписках, дает предсказуемый результат.
Безопасность внутреннего ассистента начинается с ролевой модели. Рядовой сотрудник ни при каких обстоятельствах не должен получить возможность «вытащить» из нейросети зарплатную вилку своего руководителя или чужие медицинские справки.
Когда доля корректных ответов на пилоте стабильна, а число эскалаций к человеку укладывается в норму, сценарий масштабируют и добавляют следующий. Знания обновляют по расписанию: сменился регламент по отпускам — правят источник, а не модель. Метрики держат на виду: точность ответов, доля переводов на человека, время реакции, отсутствие утечек ПДн в логах. Такой цикл превращает бота из демо в инструмент, которому доверяют и кандидаты, и сотрудники.