Чат-бот на базе LLM выдумывает факты не потому, что он «недоученный» или «плохой». Так работает сама технология: языковая модель предсказывает следующее слово по вероятности, а не сверяется с реальностью. Ожидать от нее точных ответов без единой ошибки — все равно что просить калькулятор варить кофе. Галлюцинации не исчезнут, если вы просто выберете более мощную модель. Их устраняют комбинацией готовой LLM, базы знаний и архитектуры RAG, которая заставляет бота отвечать только по вашим документам. Разберем, как это устроено: от выбора модели вроде Llama до контроля качества ответов на реальных задачах.
- Галлюцинации LLM — это не сбой, а природа технологии: модель предсказывает слова по вероятности, а не проверяет факты. Более мощная модель проблему не решит.
- Надежный корпоративный чат-бот строят на архитектуре RAG: модель отвечает только на основе найденных фрагментов из базы знаний, а не из своего обучения. Это устраняет выдумку и привязывает ответы к проверенным источникам.
- Контроль качества требует четырех механизмов: привязка к документам через системный промпт, вывод источников ответов, измеримые метрики (доля галлюцинаций и честных «не знаю») и регулярная чистка базы от устаревших данных.
- Выбор между облачными API (ChatGPT, Claude) и открытыми моделями (Llama) зависит от требований безопасности данных и наличия своей команды; для узкой задачи с хорошей базой знаний разницы в качестве почти нет.
Почему языковые модели ошибаются
LLM не хранит факты — она хранит статистические связи между словами. Когда бот отвечает на вопрос, он не заглядывает в справочник, а достраивает самую вероятную последовательность слов на основе миллиардов текстов из обучения. Иногда эта последовательность совпадает с правдой, иногда — нет. Отсюда берутся уверенные ответы с вымышленными цифрами, законами и цитатами. Миф о том, что достаточно взять модель посильнее и ошибки исчезнут, разбивается о саму архитектуру: точность зависит не от размера модели, а от того, какие данные ей дают в момент ответа.
Чат-бот — это языковая модель, а не эксперт
GPT, Claude или Llama — это движок для работы с языком. Он умеет пересказывать, структурировать, переводить и формулировать. Но он не подключен к вашим договорам, прайсам и регламентам, если вы сами их туда не передали. Спрашивать у чат-бота про внутренние процессы компании — то же, что спрашивать у случайного человека: ответ будет красивый, но наугад.
Языковая модель без подключенной базы знаний подобна блестящему оратору без профильного образования: она говорит уверенно, формулирует красиво, но совершенно не ручается за факты. Экспертность всегда лежит за пределами самой нейросети.
Экспертность появляется не внутри модели, а вокруг нее. Знания о продукте, ценах и правилах живут в ваших документах, а не в весах нейросети. Задача модели — грамотно изложить то, что ей подали на вход. Поэтому умный корпоративный ассистент — это не одна модель, а система, где LLM отвечает за язык, а база знаний отвечает за факты.
Природа галлюцинаций и вероятностная архитектура нейросетей
Галлюцинация — это не сбой, а штатный режим работы. Модель обучена всегда выдавать связный ответ, даже когда данных нет. Она не умеет говорить «я не знаю» по умолчанию: вместо пустоты она подбирает наиболее правдоподобные слова. Если в обучающих текстах рядом с вопросом часто встречались числа и даты, бот вставит число и дату — просто потому, что так статистически вероятнее.
Усугубляет ситуацию то, что модель одинаково уверенно звучит и когда права, и когда ошибается. Тон ответа не связан с его достоверностью. Пользователь видит гладкий текст и доверяет ему, а внутри — выдуманный пункт инструкции. Именно поэтому вероятностную природу модели нельзя «отключить» настройками — ее можно только ограничить внешними данными и проверками.
Ограничения встроенной памяти стандартных ботов
Знания модели заморожены на дату окончания обучения. Все, что произошло после, для нее не существует: новые тарифы, свежие приказы, обновленный ассортимент. Публичный чат-бот не знает о вашей компании ничего и не узнает, пока данные не окажутся в его контексте прямо во время запроса. Дообучение под каждый документ — дорого и медленно, поэтому в реальных проектах так почти не делают.
Есть и второе ограничение — объем окна контекста. Модель держит в поле зрения ограниченное число символов за один запрос. Загрузить в чат весь корпоративный архив нельзя: он не поместится, а если и поместится, то ответы станут дороже и медленнее. Из-за этого нужен механизм, который находит из тысяч документов только релевантные куски и подает их модели. Эту задачу решает архитектура RAG — к ней и перейдем.
🤖 ИИ-ассистент, который увеличивает конверсию
AiForSite — умный ИИ-помощник для вашего ресурса. Внедрите нейросеть за пару кликов, автоматизируйте общение с клиентами и собирайте лиды 24/7 без участия менеджера. Искусственный интеллект на ваш сайт!
Анатомия разговорного агента: превращаем языковой движок в полезный инструмент
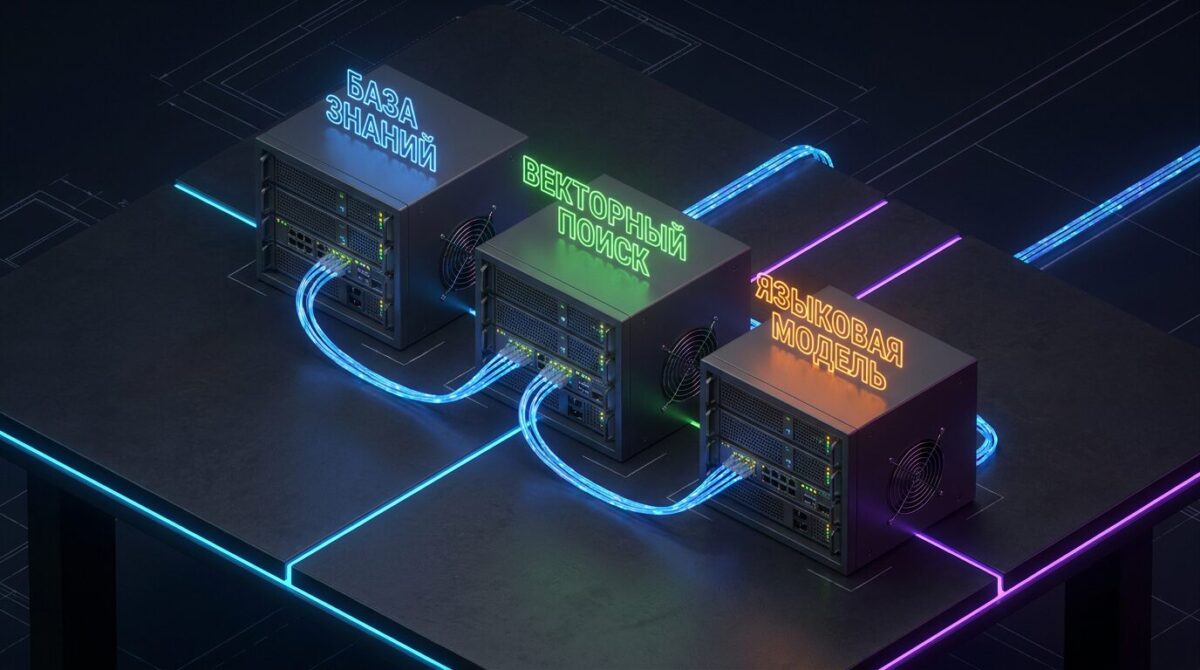
LLM умеет складывать слова в связные фразы, но не знает фактов о вашей компании. Модель обучена на текстах из интернета до определенной даты и не в курсе ваших регламентов, цен и договоров. Поэтому рабочий чат-бот собирают из трех частей: сама языковая модель как движок речи, база знаний с вашими документами и слой поиска, который подставляет нужные фрагменты в ответ. Модель отвечает не из головы, а по найденным кускам текста. Такая схема называется RAG — retrieval-augmented generation, генерация с дополнением поиском. Дальше разберем каждый компонент по отдельности.
Три кита корпоративного AI-ассистента:
- Языковая модель (LLM): Движок речи. Отвечает исключительно за понимание вопроса, пересказ и грамотность формулировок.
- Корпоративная база знаний: Хранилище фактов. Содержит очищенные от мусора инструкции, регламенты и прайсы компании.
- Слой поиска (Retriever): Связующее звено. Алгоритм, который мгновенно находит точные фрагменты в документах для передачи их в модель.
Как подружить чат-бота с корпоративными данными
Сначала документы разбивают на фрагменты по 200–500 слов и превращают каждый в вектор — числовой отпечаток смысла. Векторы складывают в специальную базу: Qdrant, Pinecone, pgvector или Elasticsearch. Когда приходит вопрос, система переводит его в такой же вектор и находит фрагменты с самым близким смыслом. Работает даже без точного совпадения слов: на запрос «сколько дней отпуска» найдется абзац про «28 календарных дней ежегодного отдыха».
Найденные куски текста подставляются в запрос к модели вместе с исходным вопросом. LLM формулирует ответ, опираясь только на переданные фрагменты. Качество зависит от базы: если регламент устарел или написан противоречиво, бот выдаст такую же путаницу. Поэтому документы чистят от дублей, разбивают логично и обновляют по расписанию. Мусор на входе даст мусор на выходе даже при идеальной архитектуре.
Что выбрать: закрытые облачные API или открытые модели вроде Llama
Облачные API — ChatGPT от OpenAI, Claude, Gemini — подключаются за несколько строк кода и не требуют своих серверов. Вы платите за объем запросов, а качество ответов выше среднего из коробки. Минус: данные уходят на сторонние серверы, что не подходит для медицинских, банковских и гостайновых сценариев. Стоимость растет вместе с нагрузкой, а модель может измениться без вашего ведома.
Открытые модели вроде Llama, Mistral или Qwen ставят на свое железо. Данные не покидают контур компании, а после покупки серверов запросы бесплатны. Расплата — расходы на видеокарты и инженеров, которые все настроят. Ответы Llama слабее топовых облачных моделей, но для узкой задачи с хорошей базой знаний разницы почти нет. Выбор упирается в требования к безопасности данных и наличие собственной команды.
| Критерий сравнения | Облачные API (ChatGPT, Claude) | Открытые модели (Llama, Mistral) |
|---|---|---|
| Безопасность данных | Данные уходят на сторонние серверы (не подходит для гостайны и банков) | Абсолютная (данные не покидают закрытый контур компании) |
| Модель оплаты | Регулярная оплата за объем запросов (токены) | Запросы бесплатны, но требуются крупные инвестиции в свои серверы с GPU |
| Сложность внедрения | Минимальная (подключение через готовый API за пару часов) | Высокая (нужна команда DevOps и ML-инженеров для настройки и поддержки) |
Усмиряем модель: зачем нужны системные инструкции и жесткие рамки
Системный промпт — это инструкция, которую бот получает перед каждым разговором. В ней прописывают роль, тон и запреты: «Отвечай только на основе переданных документов. Если ответа в них нет, скажи: данных нет, уточните у поддержки». Без такой рамки модель заполнит пробел выдумкой, лишь бы выдать связный текст. Прямой запрет фантазировать снижает долю галлюцинаций, хотя и не убирает их полностью.
Рамки не ограничиваются текстом промпта. Ответ можно проверять вторым проходом: сверять цифры и цитаты с исходными фрагментами, блокировать реплики без ссылок на источник. Температуру генерации ставят низкой, чтобы модель меньше импровизировала. Совокупность этих ограничений и превращает болтливый движок в предсказуемого помощника, который отвечает по делу или честно признается, что не знает.
Архитектура RAG: связываем чат-бота с актуальной базой знаний
RAG (Retrieval-Augmented Generation) — это схема, где LLM перед ответом сначала ищет нужные куски текста в вашей базе документов, а потом формулирует ответ на их основе. Модель перестает отвечать «из головы» и работает с фактами из ваших инструкций, договоров и регламентов. Схема простая: пользователь задает вопрос → система находит релевантные фрагменты в базе → передает их модели вместе с вопросом → LLM собирает ответ из найденного. Так вы обходите главную слабость языковой модели: она больше не придумывает данные, которых нет, а цитирует то, что вы ей дали. Дальше разберем три опоры RAG — саму базу, поиск по ней и правила ответа.
Строим базу знаний вместо безуспешных попыток обучить модель с нуля
Дообучать LLM на своих данных дорого и почти всегда лишнее. Нужны мощные видеокарты, размеченный датасет и месяцы работы, а после каждого изменения в регламенте обучение приходится повторять. RAG решает задачу иначе: модель остается прежней, а знания живут отдельно — в базе документов, которую можно обновить за минуту.
База знаний — это ваши инструкции, FAQ, техописания и внутренние правила, собранные в одном месте. Их разбивают на небольшие фрагменты (чанки) по 300–800 слов, чтобы поиск находил конкретный ответ, а не весь документ целиком. Обновили инструкцию — заменили фрагмент в базе, и бот сразу отвечает по-новому. Переобучать модель не нужно.
Векторный поиск и индексация документов для точных ответов
Чтобы найти нужный фрагмент, RAG использует векторный поиск. Каждый чанк превращают в набор чисел (эмбеддинг), который отражает смысл текста. Вопрос пользователя тоже переводят в вектор, а система ищет фрагменты с самым близким смыслом. Поэтому запрос «как вернуть товар» найдет раздел про возврат, даже если в документе написано «оформление отказа от покупки».
Векторы хранят в специальной базе — Pinecone, Weaviate, Chroma или Qdrant. Часто к векторному поиску добавляют классический по ключевым словам: гибридная схема лучше ловит и точные термины, и артикулы, и общий смысл. Индексацию запускают один раз при загрузке документов и повторяют только для измененных файлов, поэтому база остается актуальной без лишней нагрузки.
Специалисты AiForSite отмечают, что переход от классического поиска по ключевым словам к векторному снижает количество пустых ответов бота на 40%. Система начинает понимать смысловой контекст запроса пользователя, а не просто искать точные совпадения букв в документах.
Как заставить бота опираться только на проверенные источники
Даже с найденными фрагментами модель способна добавить что-то от себя. Это ограничивают системным промптом — жесткой инструкцией: «Отвечай только по приведенным документам. Если ответа в них нет, скажи, что данных недостаточно». Такая формулировка запрещает боту домысливать и снижает число выдуманных ответов.
Второй прием — ссылки на источники. Бот показывает, из какого документа взял ответ, и пользователь может проверить факт сам. Это дисциплинирует систему и делает ошибки заметными. Дополнительно ставят порог релевантности: если поиск не нашел достаточно близких фрагментов, бот честно отвечает «не знаю» вместо того, чтобы сочинить правдоподобную выдумку.
Практический контроль: как выжать максимум надежности из ответов
Надежность бота держится на четырех механизмах, а не на одном. Первый — привязка ответа к исходным документам, чтобы модель не досочиняла от себя. Второй — измеримые метрики, которые показывают, где бот врет и как часто. Третий — валидация ответов до того, как их увидит пользователь. Четвертый — регулярная чистка базы, потому что устаревший документ порождает уверенную ложь. Каждый пункт работает на снижение галлюцинаций и не требует «магической» модели. Разберем эти механизмы по отдельности: что настроить, что измерить и что проверять руками.
Избавление от галлюцинаций ИИ — это не поиск идеальной и самой дорогой нейросети. Это рутинная, но необходимая работа по выстраиванию жестких системных рамок, регулярной чистке устаревших документов и постоянному аудиту ответов на реальных пользователях.
Точность на вес золота: привязываем ИИ к исходным текстам
RAG находит подходящие фрагменты в базе и подкладывает их модели вместе с вопросом. В системном промпте прописывают жесткое правило: отвечать только по переданным фрагментам, а при их отсутствии писать «не знаю». Это отсекает ответы, придуманные из тренировочных данных модели, и оставляет только то, что подтверждено вашими документами.
Усилить привязку помогает вывод источников. Бот показывает, из какого документа и раздела взят ответ, а пользователь одним кликом сверяется с оригиналом. Ссылка на источник дисциплинирует и модель, и команду: если фрагмент нерелевантен, это сразу видно. Ответ перестает быть «черным ящиком» и превращается в проверяемую цитату из базы знаний.
Метрики качества и аудит генерации для реальных задач
Без измерений вы не отличите рабочего бота от красивой демонстрации. Собирают тестовый набор реальных вопросов с эталонными ответами и прогоняют его после каждого изменения промпта, модели или базы. Ключевые показатели: доля ответов с корректным источником, частота галлюцинаций и доля честных «не знаю» вместо выдумки. Цифры показывают, стало ли лучше после правок.
Отдельно отслеживают поведение на живых запросах. Логируют вопрос, найденные фрагменты и итоговый ответ, чтобы разобрать провалы. Часть кейсов размечает человек: ответ верен, неполон или выдуман. Такой аудит вскрывает узкие места — например, бот стабильно ошибается там, где в базе два противоречащих документа. Это подсказывает, что чинить: промпт, поиск или сами тексты.
Валидация ответов и регулярная чистка базы данных
Часть проверок автоматизируют до показа ответа пользователю. Система сверяет, что ответ опирается на найденные фрагменты, и отсекает варианты без источника. Для критичных тем — договоры, цены, юридические формулировки — подключают ручную проверку оператором. Комбинация автоматики и человека ловит ошибки, которые поодиночке ни один из них не заметит.
Точность ответа не выше качества исходного документа. Устаревший регламент или дубль с другой формулировкой заставит бота уверенно выдать неверное. Поэтому базу чистят по расписанию: убирают неактуальные версии, объединяют дубли, помечают дату проверки каждого материала. Владелец документа отвечает за его свежесть. Так база остается источником правды, а не складом противоречий.