Фраза «обучим GPT на данных вашей компании — и бот будет отвечать без ошибок» звучит красиво, но на практике не работает. Языковая модель сама выдумывает факты, путает цены и придумывает условия, которых у вас нет. Чтобы чат-бот в ВК отвечал точно, нужна не «дообученная нейросеть», а связка: база знаний, поиск по ней (RAG) и правило отвечать только по проверенным данным. Разберем три пути — конструктор вроде Senler, бот на Python через VK API и умную LLM-надстройку сверху. Покажем границы каждого варианта, стоимость владения и как сделать так, чтобы бот не врал клиентам.
- Дообучение GPT на своих данных без RAG не работает — модель все равно выдумывает факты. Решение: связка «база знаний + поиск (RAG) + правило отвечать только по проверенным данным»
- Для точных ответов нужна RAG-архитектура: система ищет релевантные фрагменты в базе знаний, передает их модели с инструкцией отвечать только по этому тексту, и цитирует источник
- Бот автоматизирует 60–80% типовых вопросов (цены, доставка, статус), но сложные и рискованные случаи должны переходить к оператору через кнопку «передать оператору»
- Выбор инструмента зависит от задачи: конструктор Senler для рассылок и кнопочных сценариев, Python-бот через VK API для интеграций с CRM и RAG-поиска по документам
Чат-боты во ВКонтакте: от простых рассылок до умных сценариев
Чат-бот в ВК решает три типа задач: отправляет рассылки и прогревает подписчиков в воронке, отвечает на частые вопросы по готовому сценарию и подключает «умный» слой на языковой модели для свободных формулировок. Под каждую задачу — свой инструмент. Для рассылок и кнопочных сценариев хватает конструктора без кода. Для нестандартной логики, интеграций с CRM и складом пишут бота на Python через VK Bots API. LLM-надстройку добавляют, когда нужно понимать вопросы клиента в свободной форме. Слои комбинируют по мере роста нагрузки — смешивать их в одном решении необязательно.
Зачем бизнесу чат-бот: база и ключевые задачи
Бот снимает с менеджеров повторяющиеся действия: отвечает на вопросы о цене, часах работы, доставке и статусе заказа круглосуточно. По сценарию он собирает заявку, записывает на услугу, отправляет промокод и напоминает о брошенной корзине. Это разгружает поддержку и сокращает время первого ответа — фактор, который влияет на конверсию из обращения в продажу.
Второй пласт задач — маркетинг. Через бота сегментируют подписчиков, запускают цепочки прогрева и рассылки по событию: подписался, оставил заявку, купил. В ВК рассылки бота работают только для тех, кто сам написал сообществу, — это требование площадки против спама. Поэтому базу подписчиков собирают честно, через подписные страницы и кнопки в постах, а не выгружают откуда-то со стороны.
Быстрый старт: конструкторы Senler, GetCourse и их альтернативы
Senler — самый массовый конструктор рассылок и воронок для ВК. Собираете цепочки сообщений, кнопочные меню и подписные страницы мышкой, без кода. Работает через официальную интеграцию с ВК, поэтому проходит модерацию и не блокирует сообщество. Базовый тариф стартует от нескольких сотен рублей в месяц, цена растет с числом подписчиков в базе. Этого хватает для FAQ, автоворонок и напоминаний.
| Подход к созданию бота | Идеально подходит для | Главный минус |
|---|---|---|
| Конструкторы (Senler, BotHelp) | Рассылки, кнопочные меню, простые автоворонки | Жесткая логика, бот ломается при вопросах не по сценарию |
| Кастомный код (Python + API) | Интеграция с внутренней CRM, сложные расчеты стоимости | Требует разработчика, затраты на хостинг и поддержку |
| LLM + RAG архитектура | Ответы на свободные вопросы с опорой на базу знаний | Риск галлюцинаций при некачественной подготовке документов |
GetCourse решает более широкую задачу — это платформа для онлайн-школ с уроками, оплатами и рассылками, где бот ВК лишь один из каналов. Из альтернатив под ВК используют BotHelp, Salebot и Textback. Граница конструкторов одна: они хорошо ведут клиента по заранее нарисованному дереву, но плохо справляются с вопросами не по сценарию. Как только логика упирается в кнопки, а клиенты пишут свободным текстом, переходят к коду или LLM-слою.
Гибкие решения на Python: возможности VK API
Когда сценарий сложнее дерева кнопок, бота пишут на Python через VK Bots API. Два способа получать сообщения: Long Poll — сервер сам опрашивает ВК, подходит для старта и не требует внешнего домена; Callback API — ВК шлет события на ваш сервер по HTTPS, надежнее под нагрузкой. Библиотеки vk_api и vkbottle забирают на себя авторизацию по токену сообщества и разбор входящих событий.
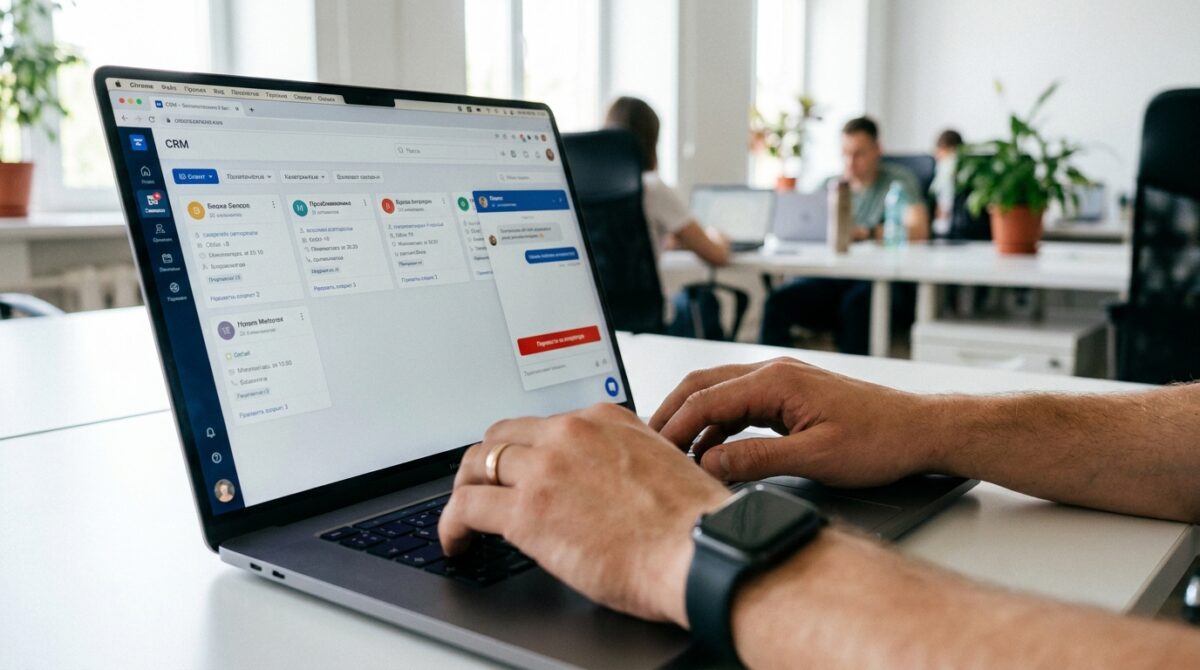
На Python бот делает то, что недоступно конструктору: ходит в вашу CRM за статусом заказа, проверяет остаток на складе, считает стоимость по параметрам и пишет данные в базу. Здесь же закладывают маршрутизацию — кнопку «передать оператору», чтобы спорный вопрос уходил живому сотруднику. Плата за гибкость — хостинг, поддержка кода и обработка ошибок API. Именно на этот слой позже навешивают RAG-поиск по документам, о котором пойдет речь дальше.
🤖 ИИ-ассистент, который увеличивает конверсию
AiForSite — умный ИИ-помощник для вашего ресурса. Внедрите нейросеть за пару кликов, автоматизируйте общение с клиентами и собирайте лиды 24/7 без участия менеджера. Искусственный интеллект на ваш сайт!
Искусственный интеллект: как LLM меняют возможности ботов
Обычный бот на сценарии работает по жесткому дереву: нажал кнопку — получил заранее записанный ответ. LLM ломает эту схему. Она понимает вопрос, заданный своими словами, и формулирует ответ на лету. Клиент пишет «а можно оплатить частями?» вместо поиска нужного пункта меню — и получает связный текст. Это снимает главное ограничение кнопочных ботов: невозможность предугадать все формулировки. Но за гибкость приходится платить: модель отвечает уверенно даже когда не знает ответа и придумывает несуществующие детали. Дальше разберем, как устроена эта технология и как заставить ее опираться на ваши данные, а не на фантазию.
Автоматизация диалогов с помощью больших языковых моделей
LLM закрывает поток однотипных вопросов, на которые оператор тратит рабочее время: график работы, статус заказа, условия доставки, возврат. Модель разбирает свободный текст и отвечает без строгого сценария, поэтому клиенту не нужно угадывать формулировку из меню. Один бот держит десятки диалогов параллельно и не устает к вечеру.
Но автоматизация не означает «отдать все нейросети». Рабочая схема — разделить задачи: простые повторяющиеся вопросы уходят боту, сложные и спорные случаи маршрутизируются к человеку через кнопку «передать оператору». Так бот снимает нагрузку на 60–80% типовых обращений, а живой сотрудник подключается там, где нужна ответственность за решение.
Автоматизация ради автоматизации — прямой путь к потере лояльности. По опыту компании AiForSite, оптимальный баланс достигается, когда нейросеть закрывает до 80% рутинных обращений, а все нестандартные и конфликтные ситуации мгновенно переводятся на живого сотрудника.
Как работает архитектура LLM и почему ей стоит доверять
LLM предсказывает следующее слово на основе статистики: она видела миллиарды текстов и рассчитывает, какое продолжение вероятнее. Это не база фактов и не поисковик — модель не «знает» ваши цены, она генерирует правдоподобный текст. Отсюда галлюцинации: если данных о вашем товаре в ответе нет, модель дорисует их сама, и выглядеть это будет убедительно.
Доверять стоит не самой модели, а связке модель + retrieval. Схема RAG сначала ищет нужный фрагмент в вашей базе знаний, затем передает его модели с командой отвечать только по этому тексту. Модель отвечает за формулировку, база — за факты. Плюс контроль: логирование диалогов, цитирование источника и запрет отвечать, если данных не нашлось. Тогда ответам можно верить.
Почему обучение GPT на своих данных без RAG — это миф
«Дообучение» (fine-tuning) меняет стиль и манеру ответов модели, но не превращает ее в надежный справочник. Модель не запоминает цены и условия как строки в таблице — она размывает их в статистике весов. После обучения на прайсе бот все равно выдаст выдуманную цифру, если формулировка вопроса отклонится от того, что было в данных. А обновить один пункт прайса без переобучения всей модели нельзя.
Загрузить прайс-лист в нейросеть и надеяться на чудо бессмысленно. Обычное дообучение не заставит ИИ выучить ваши цены наизусть — модель просто размажет их по своим алгоритмам и в нужный момент выдаст убедительно звучащую, но совершенно выдуманную цифру.
RAG решает обе проблемы. Данные лежат отдельно, в базе знаний, и модель обращается к ним в момент ответа. Поменялась цена — вы правите один документ, а не гоняете переобучение. Модель цитирует конкретный источник, поэтому ответ можно проверить. Fine-tuning уместен для тона общения, но точность фактов дает только внешний поиск по утвержденной базе с фильтрами и правилом «нет данных — не выдумывай».
RAG и база знаний: как добиться точности ответов
Точность бота зависит не от модели, а от данных, которые вы ей передаете перед ответом. Вот как это работает: клиент задает вопрос, система ищет подходящие фрагменты в вашей базе знаний, передает их модели и требует ответить только по ним. Если релевантных данных нет, бот честно говорит, что не знает, и зовет оператора. Так работает RAG (Retrieval-Augmented Generation) — именно эта связка отличает рабочего бота от генератора красивых, но выдуманных фраз. Дальше разберем, как устроен RAG, как собрать базу знаний и как проверять ответы, чтобы бот не сочинял цены и условия.
Retrieval-Augmented Generation: фундамент для умного бота
RAG делит работу на два шага. Сначала retrieval — поиск: вопрос клиента превращают в вектор (числовое представление смысла), по нему ищут похожие куски текста в базе. Затем generation: найденные фрагменты вместе с вопросом уходят в модель с инструкцией «отвечай только по этому тексту». Модель не вспоминает факты из обучения, а пересказывает то, что ей дали. Это снижает выдумки, потому что источник ответа — ваши документы, а не память нейросети.
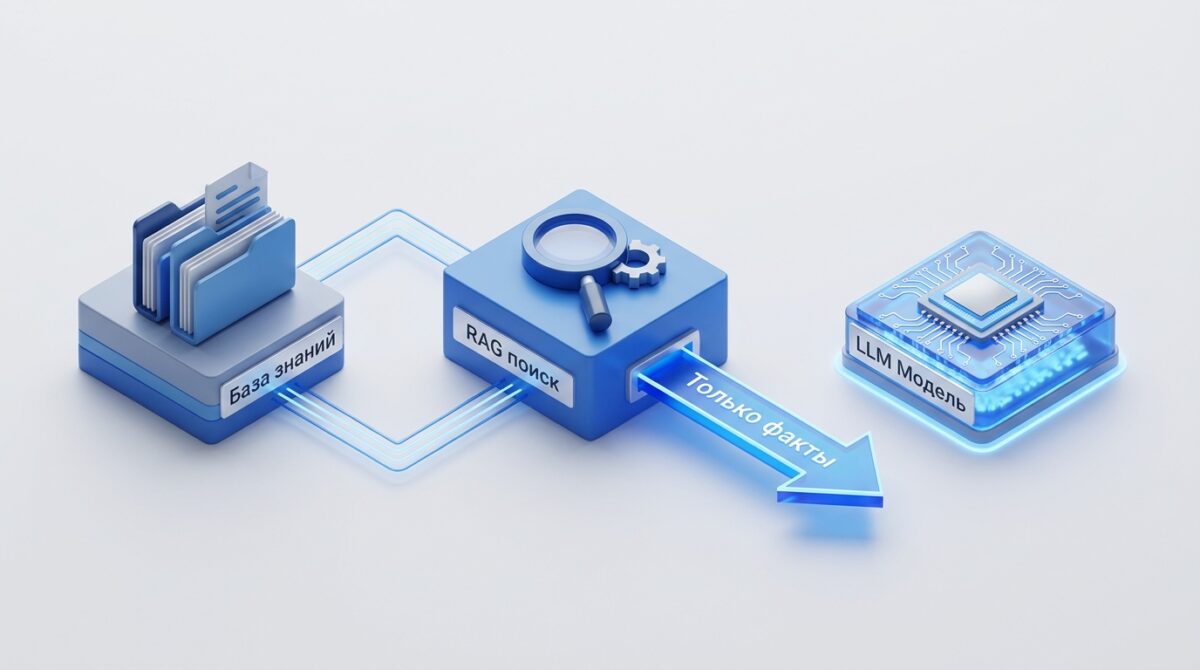
Ключевой параметр — что именно нашел поиск. Если retrieval вернул нерелевантный фрагмент, модель ответит по нему и ошибется. Поэтому базу разбивают на смысловые куски (чанки) по 200–500 слов, добавляют метаданные вроде раздела и даты обновления и настраивают порог релевантности. При низкой оценке совпадения бот не отвечает вовсе — это лучше, чем уверенная ошибка.
Готовим базу знаний: от документов до структурированных данных
База знаний — это не свалка файлов, а вычищенный набор проверенных ответов. Начните с того, что клиенты спрашивают чаще всего: условия доставки, цены, гарантия, режим работы, возвраты. Соберите эти данные в отдельные короткие документы с одним смыслом на фрагмент. Длинные PDF с договорами и презентации с картинками для поиска плохи — их режут на части, а таблицы и прайсы выносят в структурированный формат, чтобы бот не путал цифры.
Отдельно решите вопрос актуальности. Если цена в базе устарела, бот назовет старую и подставит компанию. Заведите правило: источник ответов один, обновляется в одном месте, у каждого фрагмента есть дата. Динамические данные — остатки, статус заказа, свободные слоты — не храните в базе знаний, а подтягивайте запросом к вашей CRM или сайту через инструмент (function calling), чтобы цифры были живыми.
- Дробите информацию: Один документ должен содержать ответ только на один конкретный вопрос (например, только условия возврата).
- Избегайте сложных форматов: Переведите многостраничные PDF-презентации в простой текст.
- Структурируйте цифры: Прайс-листы и таблицы с характеристиками лучше хранить в строгих форматах, а не сплошным текстом.
- Назначьте ответственного: База знаний должна иметь единый центр обновления, чтобы избежать рассинхронизации данных.
Контроль качества: проверка фактов, цитирование и фильтры
Заставьте бота показывать, откуда взят ответ. В промпте задайте инструкцию: приводить ссылку или название раздела базы, из которого получен факт. Цитирование источника решает две задачи — клиент видит, что информация не с потолка, а вы при разборе спорного диалога находите, какой фрагмент дал сбой. Если модель отвечает без опоры на найденный текст, такой ответ отсекают фильтром на выходе.
Добавьте жесткие запреты: не называть цены и сроки, которых нет в базе, не обещать скидки, не давать юридических и медицинских советов. Часть проверок делают правилами до показа ответа — например, регуляркой ловят выдуманные суммы или контакты. Логируйте все диалоги и считайте метрики: доля ответов «не знаю», число переключений на оператора, оценки клиентов. Это честнее обещаний «без галлюцинаций» и показывает реальное качество.
Человек в контуре: когда пора переключать диалог на оператора
Кнопка «передать оператору» — не признак слабого бота, а обязательный элемент. Бот берет на себя повторяющиеся вопросы, а сложные и рискованные отдает человеку. Настройте автопереключение по триггерам: retrieval не нашел релевантных данных, клиент дважды переспросил, всплыли слова «жалоба», «вернуть деньги», «суд», речь идет об оплате или персональных данных. Так бот не загоняет человека в тупик заученными фразами.
Передача должна быть бесшовной. Оператор получает всю историю диалога, чтобы клиент не пересказывал проблему заново. Если операторы офлайн, бот честно называет часы работы и фиксирует контакт для обратного звонка, а не имитирует ответ. Этот контур снимает главный риск умного бота: там, где цена ошибки высока — деньги, договор, конфликт — решает человек, а автоматика лишь ускоряет рутину.
Запуск и развитие ИИ-бота: практика и мониторинг
Бот не заработает точно с первого дня — его запускают в тестовом режиме на узком сценарии и расширяют по мере накопления данных. Сначала подключите один канал: ответы на частые вопросы по базе знаний. Проверьте 50–100 реальных диалогов вручную: где бот выдумал факт, где не нашел ответ, где стоило передать оператору. Соберите список провалов и добавьте недостающие документы в базу или ужесточите фильтры retrieval. Только после этого открывайте бота на весь поток. Дальше работа не заканчивается: диалоги нужно логировать, а базу знаний обновлять при каждом изменении цен и условий, иначе бот начнет отвечать по устаревшим данным.
Что выбрать: готовый ИИ-конструктор или кастом на Python
Конструктор вроде Senler подойдет, если задачи — рассылки, воронки и ответы на типовые вопросы по кнопкам. Настройка идет без кода, запуск занимает день-два, а стоимость складывается из тарифа сервиса и времени маркетолога. Границы такого решения: сложную логику и поиск по большим документам собрать не получится, а LLM-слой подключают отдельным сервисом сверху. Это дешевый и быстрый старт для малого бизнеса.
Кастом на Python через VK Bots API нужен, когда бот работает с корпоративной базой документов, интегрируется с CRM и требует RAG-поиска с цитированием источников. Тут выше порог входа: нужен разработчик, сервер, настройка Callback API или Long Poll. Стоимость владения складывается из хостинга, оплаты запросов к LLM и поддержки кода. Зато вы контролируете фильтры, запреты на выдумывание и маршрутизацию к оператору.
Выбор между визуальным конструктором и собственным кодом — это всегда компромисс между скоростью запуска и глубиной контроля. Если вам нужна интеграция с CRM и строгий поиск по корпоративным документам, без кастомной разработки обойтись не получится.
Метрики успеха: как оценивать и улучшать работу бота
Оценивайте бота не по ощущению «стало удобнее», а по цифрам. Ключевые метрики: доля вопросов, на которые бот ответил без передачи оператору (уровень автоматизации), доля ответов с корректной ссылкой на источник и процент диалогов, где клиент переспросил или пожаловался. Отдельно считайте случаи выдуманных фактов — для этого выборочно проверяйте логи вручную. Эти данные показывают, где база знаний пустая, а где фильтры retrieval пропускают мусор.
Улучшение идет циклами. Раз в неделю выгружайте диалоги, где бот не нашел ответ или ошибся, и правьте причину: добавляйте документы, уточняйте формулировки, настраивайте порог релевантности поиска. Метрику качества сравнивайте до и после правок — так вы видите реальный прогресс, а не обещания «без галлюцинаций». Бот, который передает сложный вопрос человеку, лучше бота, который уверенно выдумывает ответ.