Залить документы в ChatGPT и получить бота, который знает ваш бизнес наизусть — так не работает. Модель не запоминает файлы, а дообучение собственной GPT с нуля стоит как отдельный отдел разработки и все равно выдаст галлюцинации. Есть способ проще и надежнее — RAG. Это когда бот не «зубрит» ваши данные, а обращается к базе знаний в момент ответа: находит нужный кусок из инструкций, договоров или регламентов и отвечает по нему. Разберем, чем обучение ChatGPT на собственных данных отличается от подключения через RAG, почему второй вариант дешевле и как собрать такого бота из готовой LLM и ваших документов.
- Дообучение ChatGPT на корпоративных данных неэффективно: стоит десятки тысяч рублей за прогон, модель путает факты и не отделяет знание от вымысла, требует переобучения при каждом обновлении данных
- RAG (Retrieval-Augmented Generation) — это архитектура, где бот не запоминает документы, а обращается к внешнему хранилищу в момент ответа, находя нужные фрагменты и указывая источник
- RAG дешевле и безопаснее: использует готовую LLM через API, данные остаются в компании, обновляются без переобучения, ответы проверяемы и содержат ссылки на источники
- Успех RAG зависит от подготовки данных: нужно собрать актуальные источники, нарезать на фрагменты (чанки по 200–500 слов), векторизовать через эмбеддинги и настроить регулярное обновление индексов
Почему дообучение нейросетей — плохая идея для бизнеса
Обучить базовую LLM под свои веса бизнесу недоступно: тренировка модели с нуля требует тысяч видеокарт, терабайтов текста и команды ML-инженеров. Даже частичное дообучение готовой GPT под конкретную компанию упирается в три проблемы. Первая — деньги: каждый прогон датасета на мощных GPU стоит десятки и сотни тысяч рублей. Вторая — данные быстро устаревают: изменили прайс или регламент, и модель снова нужно переучивать. Третья — модель не отделяет знание от вымысла и продолжает выдумывать факты. Поэтому вместо переобучения весов компании подключают данные через внешний слой поиска — RAG.
Попытка дообучить GPT на своих данных — это как топить печь ассигнациями. Дорого, неэффективно, а данные устаревают быстрее, чем модель успевает их выучить.
Почему нельзя просто загрузить файлы в ChatGPT
Когда вы прикрепляете PDF к чату, модель не запоминает его. Файл попадает в контекст одного диалога, а после закрытия сессии данные исчезают. В следующем разговоре бот снова ничего не знает о вашем документе. Загрузка файла — это не обучение, а разовая подсказка на время беседы.
У контекста есть предел: модель держит в голове ограниченное число токенов. База из тысячи договоров туда не влезет — придется резать текст. Отсюда и путаница: бот отвечает по случайному куску или заявляет, что информации нет. Чтобы данные работали постоянно и без потерь, их выносят во внешнее хранилище, откуда бот подтягивает нужный фрагмент под каждый вопрос.
Fine-tuning против реальных задач компании
Fine-tuning тонко настраивает модель под формат и стиль ответов: научить бота отвечать в фирменном тоне, использовать шаблон письма или классифицировать заявки. Это работает, когда задача — как отвечать, а не что знать. Для стиля и структуры дообучение уместно и дает результат.
Но передать через fine-tuning конкретные факты — цены, условия, номера статей регламента — плохая затея. Модель усредняет данные в весах и не гарантирует точную цитату: вместо суммы из договора она может выдать похожую, но неверную цифру. Обновили прайс — датасет собирают заново и запускают новый прогон. Для меняющихся фактов нужен подход, где данные лежат отдельно и подставляются в ответ напрямую.
Риск галлюцинаций при обучении на «сырых» данных
Галлюцинация — это уверенный ответ, который звучит правдоподобно, но не соответствует реальности. LLM устроена так, что достраивает наиболее вероятное продолжение фразы, а не сверяется с источником. Если скормить ей неструктурированные документы через дообучение, она смешает факты из разных файлов и выдаст правдоподобную выдумку.
Чем противоречивее и грязнее датасет — дубли, устаревшие версии, обрывки таблиц — тем чаще бот путает данные. Проверить, откуда он взял ответ, при дообучении нельзя: факт растворен в весах без ссылки на источник. RAG решает это иначе — модель отвечает только по найденному фрагменту и указывает, из какого документа он взят, поэтому ответ можно проверить.
🤖 ИИ-ассистент, который увеличивает конверсию
AiForSite — умный ИИ-помощник для вашего ресурса. Внедрите нейросеть за пару кликов, автоматизируйте общение с клиентами и собирайте лиды 24/7 без участия менеджера. Искусственный интеллект на ваш сайт!
Архитектура RAG: как подружить чат-бота с вашими документами
RAG состоит из четырех слоев, каждый решает свою задачу. Первый — готовая LLM: вы берете модель через API (GPT, Claude, YandexGPT) или разворачиваете он-прем, не трогая ее веса. Второй — корпоративный датасет: регламенты, базы вопросов, договоры, инструкции. Третий — векторное или полнотекстовое хранилище, куда эти документы попадают в удобном для поиска виде. Четвертый — слой поиска, который в момент запроса достает нужные фрагменты и передает их модели вместе с вопросом пользователя. Модель ничего не запоминает — она отвечает по тому, что ей подсунули прямо сейчас. Разберем, как эти части работают вместе.
| Критерий сравнения | Fine-tuning (Дообучение) | RAG-архитектура |
|---|---|---|
| Обновление знаний | Требует полного переобучения модели на новом датасете. Дорого и долго. | Достаточно обновить/добавить документ в базу и переиндексировать. Быстро и дешево. |
| Контроль источников | Невозможно отследить, откуда модель взяла конкретный факт. Ответ — «черный ящик». | Ответ всегда сопровождается ссылкой на конкретный фрагмент документа-источника. Полная прозрачность. |
| Риск «галлюцинаций» | Высокий. Модель смешивает знания и может выдумать правдоподобный, но ложный факт. | Низкий. Модель ограничена контекстом из найденных документов и инструкцией «не выдумывать». |
| Безопасность данных | Конфиденциальные данные «растворяются» в весах модели, есть риск утечки. | Данные хранятся в периметре компании, в LLM передается только временный контекст для одного ответа. |
Как работает Retrieval-Augmented Generation: от поиска до ответа
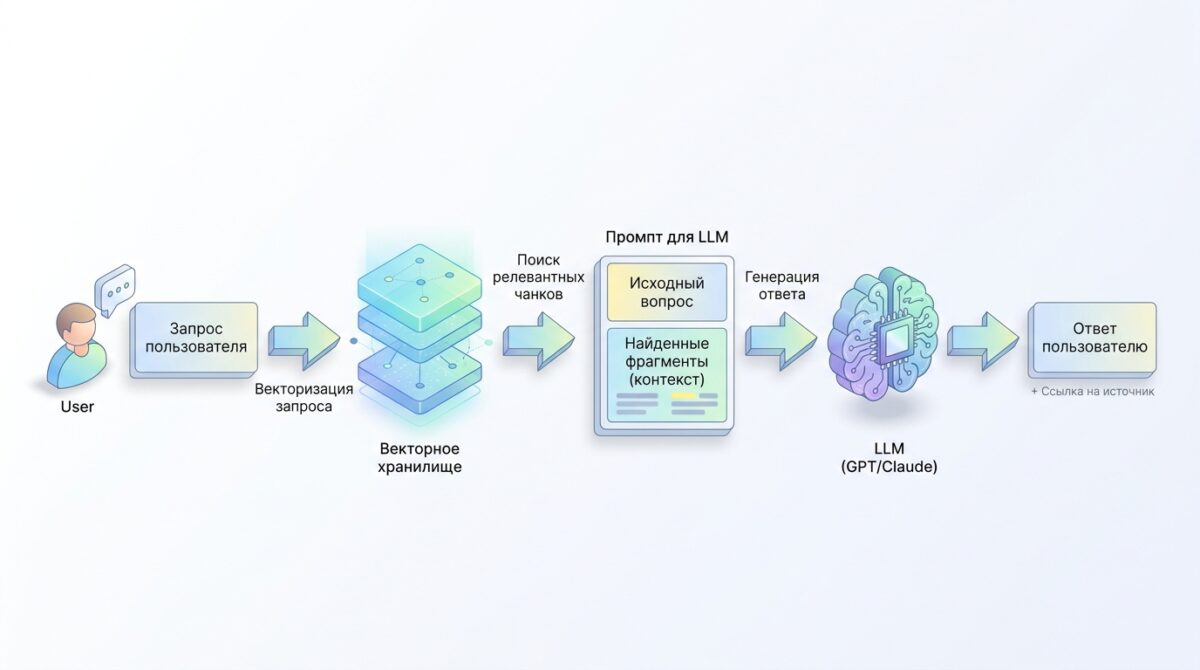
Сначала ваши документы режут на фрагменты по 200–500 слов и прогоняют через модель эмбеддингов — она превращает каждый кусок в вектор, набор чисел, отражающий смысл текста. Эти векторы складывают в хранилище: Pinecone, Weaviate, Qdrant или расширение pgvector в обычном PostgreSQL. Теперь поиск идет не по точному совпадению слов, а по смыслу: запрос «как вернуть товар» найдет фрагмент про «процедуру возврата», даже если формулировки не совпадают дословно.
Дальше запускается цепочка из трех шагов. Пользователь задает вопрос — система переводит его в вектор — хранилище отдает 3–5 самых близких по смыслу фрагментов. Эти фрагменты вместе с исходным вопросом склеиваются в один промпт и уходят в LLM. Модель формулирует ответ, опираясь на переданный текст, а не на то, что она «помнит» из обучения. В итоге бот отвечает по вашему регламенту от прошлой недели, хотя саму модель обучали годами раньше.
Почему RAG — самый надежный способ передачи знаний ИИ
Fine-tuning вшивает знания в веса модели: чтобы обновить прайс или регламент, придется заново готовить датасет и запускать обучение. RAG обновляется иначе — вы просто загружаете новый документ в хранилище, и бот подхватывает его в следующем же ответе. Изменился тариф — заменили файл, и все актуально без переобучения. Это делает RAG подходящим для данных, которые меняются часто: цены, наличие, условия акций, свежие инструкции.
Второй плюс — прозрачность. При RAG видно, из какого именно фрагмента бот взял ответ, поэтому легко показать источник и проверить корректность. Fine-tuning так не умеет: модель выдает результат, но откуда он взялся — не отследить. Плюс конфиденциальные данные остаются в вашем хранилище, а не растворяются в весах модели, которую вы не контролируете. Для документов с коммерческой тайной это критично.
Связываем внешнюю базу данных с LLM через API
LLM не лезет в вашу базу напрямую — между ними стоит слой-оркестратор. Его собирают на фреймворках вроде LangChain или LlamaIndex либо пишут вручную. Оркестратор принимает запрос, ходит в векторное хранилище за фрагментами, формирует промпт и вызывает модель через API. Если данные лежат в CRM или SQL-базе, добавляют коннекторы: бот сначала делает запрос к таблице, получает актуальную цифру, а потом отдает ее модели для формулировки ответа человеческим языком.
Такая схема разделяет ответственность. Модель отвечает только за язык и логику изложения, а за факты отвечает ваша база. Захотели сменить GPT на Claude или локальную модель — меняете один вызов API, а хранилище и данные остаются на месте. Это защищает от привязки к одному поставщику и позволяет держать чувствительные данные на своих серверах, отправляя в облачную LLM только нужный для конкретного ответа фрагмент.
Ключевое преимущество RAG — полный контроль над данными. Специалисты AiForSite отмечают, что конфиденциальная информация остается внутри компании, а не растворяется в ‘мозгах’ нейросети, что критически важно для бизнеса.
Как контекст помогает бороться с галлюцинациями
Галлюцинации возникают, когда модель не знает ответа, но все равно его выдумывает — складывает правдоподобные слова без опоры на факты. RAG убирает почву для фантазий: вместе с вопросом модель получает готовый фрагмент с ответом. Ей не нужно ничего додумывать — материал уже перед глазами. Инструкция в промпте усиливает эффект: «отвечай только по переданному тексту, при нехватке данных скажи, что информации нет». Так бот честно признает пробел вместо выдумки.
Готовим данные: превращаем хаос в структурированную базу
Качество ответов бота зависит не от модели, а от того, что вы ей дадите на вход. RAG находит фрагменты в вашей базе и подставляет их в ответ, поэтому мусорные данные дадут мусорный результат. Если инструкции лежат в почте, регламенты в PDF, а прайс в Excel десятилетней давности — бот будет путаться и выдавать устаревшие цифры. Подготовка данных занимает больше времени, чем настройка самой связки, но именно она определяет, будет ли бот полезным. Разберем три этапа: собрать и почистить материалы, разбить их на фрагменты и превратить в векторы, затем настроить регулярное обновление базы.
Инвентаризация знаний: что нужно подготовить перед стартом
Соберите все источники, к которым бот должен обращаться: базу знаний поддержки, регламенты, договоры, FAQ, описания продуктов, скрипты продаж. Отсеките дубли и устаревшие версии — если в базе два прайса за разные годы, бот процитирует случайный. Приведите форматы к тексту: сканы прогоните через распознавание, таблицы выгрузите в CSV или Markdown, из PDF извлеките чистый текст без колонтитулов и водяных знаков.
Разбейте документы на фрагменты по 200–500 слов — чанки. Модель ищет ответ не по всему файлу целиком, а по кускам, поэтому длинный договор на 40 страниц нужно нарезать на смысловые блоки: один пункт — один чанк. К каждому фрагменту добавьте метаданные: источник, дату, раздел. Так бот сможет ссылаться на конкретный документ, а вы — фильтровать выдачу по актуальности.
Векторизация: как превратить текст в понятные машине смыслы
Машина не понимает слова напрямую — она работает с числами. Векторизация переводит каждый чанк в набор чисел (эмбеддинг), который описывает смысл фрагмента. Тексты с близким значением получают близкие векторы: запрос «как вернуть товар» и абзац про правила возврата окажутся рядом в векторном пространстве, даже если в них нет одинаковых слов. Для перевода используют модели эмбеддингов — например, от OpenAI или открытые аналоги.
- Инвентаризация. Соберите все источники знаний (регламенты, FAQ, инструкции), которые должны быть доступны боту.
- Очистка. Удалите дубликаты, устаревшие версии документов и нерелевантную информацию.
- Конвертация. Приведите все файлы к текстовому формату (например, извлеките текст из PDF и отсканированных JPG).
- Структурирование и нарезка. Разбейте длинные документы на короткие, семантически завершенные фрагменты (чанки) по 200-500 слов.
- Обогащение метаданными. Каждому чанку присвойте теги: источник, дата создания, автор, тема. Это улучшит точность поиска.
Готовые векторы складывают в векторное хранилище — Qdrant, Pinecone, Weaviate или pgvector поверх обычного PostgreSQL. Когда приходит вопрос пользователя, его тоже переводят в вектор и ищут в базе ближайшие по смыслу фрагменты. Найденные куски подставляются в промпт как контекст, и модель отвечает уже по ним. Так бот отвечает по вашим данным, а не по общим знаниям из обучения — отсюда и снижение галлюцинаций.
Зачем нужна регулярная индексация данных
База знаний живет: меняются цены, выходят новые регламенты, старые условия отменяют. Если проиндексировать документы один раз и забыть, через месяц бот начнет отвечать по устаревшим данным — и это опаснее, чем отсутствие ответа. Индексация — это процесс, в котором новые и измененные документы нарезаются на чанки, векторизуются и добавляются в хранилище, а неактуальные удаляются.
Настройте обновление под ритм ваших данных: прайс, который меняется еженедельно, переиндексируйте по расписанию, а редкие регламенты — вручную при правках. Удобно повесить индексацию на триггер: обновили файл в общей папке или CRM — запустился пересбор. Метаданные с датами помогают отслеживать, какие фрагменты давно не трогали, и вовремя чистить базу от устаревших версий.
Реализация: безопасность, контроль и масштабируемость
RAG-бот держит данные под контролем компании: сама LLM их не запоминает и не смешивает с чужими запросами. Документы лежат в вашем хранилище, а модель получает только тот фрагмент, который нужен для конкретного ответа. Это решает три задачи сразу: безопасность — тексты не уходят в веса модели и не всплывают в чужих диалогах; контроль — ответы строятся на проверенных источниках, а не на предположениях; масштабируемость — базу знаний пополняют без переобучения: добавили регламент, переиндексировали, бот сразу отвечает по-новому. Дальше разберем, где физически лежат данные, как ограничить ответы бота и почему такая схема дешевле.
Где на самом деле хранятся данные компании
Данные не попадают внутрь модели. Они остаются в вашем хранилище — векторной базе (Qdrant, Weaviate, pgvector) или полнотекстовом индексе. Туда загружают договоры, инструкции, базу тикетов, документы разбивают на фрагменты и переводят в векторы. Модель обращается к этому хранилищу по запросу: получает подходящий кусок текста, использует его как контекст и формирует ответ. После ответа фрагмент нигде не оседает.
Хранилище можно развернуть на своих серверах (он-прем) или в приватном облаке — тогда документы не покидают периметр компании. Доступ к базе разграничивают по ролям: юрист видит договоры, поддержка — инструкции. Обновление данных не требует трогать саму LLM: заменили файл, переиндексировали фрагмент — и бот отвечает по актуальной версии. Модель при этом остается неизменной готовой LLM через API или в своем контуре.
Управление ответами: настраиваем системные промпты и ограничения
Поведение бота задают системным промптом — инструкцией, которую модель получает перед каждым запросом. В ней прописывают роль, тон, формат ответа и границы: «отвечай только по документам из базы», «не найдя данных, скажи об этом, а не выдумывай». Это отсекает галлюцинации: бот опирается на переданный контекст, а не на общие знания модели. Если нужного фрагмента в базе нет, он честно сообщает, что информации не хватает.
RAG-бот — это зеркало вашей базы знаний. Если в ней царит хаос из дублей и устаревших файлов, бот будет уверенно врать, ссылаясь на мусорные данные.
Поверх промпта настраивают фильтры и правила. Можно ограничить темы, запретить раскрывать внутренние данные конкретным ролям, задать шаблоны ответов для типовых запросов. Для формата ответов подключают ограниченный fine-tuning или инструкционную настройку — когда модель учат отвечать в нужном стиле, а не наполняют новыми фактами. Факты остаются в хранилище, а настройка отвечает за то, как бот их подает.
Почему RAG выгоднее обучения модели с нуля
Обучение своей LLM с нуля — это тысячи GPU-часов, команда ML-инженеров и датасет на миллиарды токенов. Даже полноценное дообучение базовой модели под свои веса бизнесу практически недоступно и не гарантирует точности: модель все равно может путать факты. RAG обходится готовой LLM и вашим хранилищем — расходы сводятся к подготовке данных, индексации и оплате API или сервера. Запустить пилот можно за недели, а не за год.
Главное отличие — гибкость. Дообученную модель для обновления знаний пришлось бы переобучать заново. В RAG данные меняют на лету: обновили документ — бот сразу отвечает по нему. Плюс прозрачность: видно, из какого источника взят ответ, а значит, его можно проверить. Поэтому связка «готовая LLM + база знаний + RAG-слой» стала массовым решением — дешевле, безопаснее и управляемее, чем обучение чат-бота на своих данных с чистого листа.